
Qué es un RAG: definición, funcionamiento y usos
- Qué es un RAG (generación aumentada por recuperación)
- Cómo funciona RAG en IA: paso a paso
- Para qué sirve un RAG: beneficios
- RAG con documentos propios
- Cuándo usar un RAG: casos de uso
- Cómo preparar documentos para RAG
- RAG local frente a RAG en la nube: cuál es la diferencia
- Cómo usar RAG con tus documentos en iBoomto AI
- Preguntas frecuentes
- Conclusión
¿Qué es un RAG? Un RAG es un sistema que permite a un modelo de IA buscar información en tus documentos antes de responder. Su nombre completo es generación aumentada por recuperación, y RAG son las siglas de Retrieval-Augmented Generation, en inglés.
Un modelo de lenguaje sin RAG responde con lo que aprendió durante su entrenamiento. Esa información puede estar desactualizada o no incluir tus archivos. Un RAG añade un paso de búsqueda: localiza los fragmentos relevantes y se los entrega al modelo junto con la pregunta.
Ejemplo hipotético
- Sin RAG: el modelo puede responder con una cifra general que no procede del manual.
- Con RAG: el sistema localiza el apartado de vacaciones del manual y el modelo responde a partir de ese texto.
Esta guía explica cómo funciona y para qué sirve un RAG. También indica cuándo usarlo, cómo preparar tus documentos y qué cambia entre un RAG local y uno en la nube.
Qué es un RAG (generación aumentada por recuperación)
Un RAG en IA combina un buscador de documentos con un modelo de lenguaje para que las respuestas partan de fuentes concretas. La generación aumentada por recuperación consiste en buscar primero la información relevante y redactar después la respuesta con ella.
Qué es RAG y qué significa en IA
RAG es una técnica de IA que añade una fase de búsqueda antes de que el modelo genere texto. Su nombre procede de Retrieval-Augmented Generation, que en español se traduce como generación aumentada por recuperación.
Para entender qué es un RAG en IA basta con recordar dos verbos: recuperar y generar. Primero se recuperan fragmentos de documentos. Después, el modelo genera la respuesta a partir de ellos.
Un RAG no es un modelo, es un sistema
Un RAG no es un modelo de IA, sino un sistema formado por varias piezas que trabajan juntas. Por eso se usa «RAG» para nombrar la técnica y «un RAG» para nombrar el sistema que la aplica.
- Documentos fuente: los archivos que quieres consultar, como manuales, informes o notas.
- Índice: los documentos divididos en fragmentos y organizados para poder buscarlos.
- Recuperador: la pieza que localiza los fragmentos más relevantes para cada pregunta.
- Modelo de lenguaje (LLM): el modelo que redacta la respuesta a partir de esos fragmentos.
El resultado depende de todas las piezas. Si el recuperador falla, el modelo recibe fragmentos poco útiles.
En qué se diferencia de un LLM sin más
Un LLM sin más responde solo con lo que aprendió durante su entrenamiento, mientras que un RAG consulta además tus documentos antes de generar la respuesta. El RAG no sustituye al LLM: lo utiliza como una de sus piezas.
| Aspecto | LLM sin RAG | RAG |
| Fuente de la información | Entrenamiento del modelo | Entrenamiento del modelo y documentos consultados |
| Datos propios | No los conoce | Los consulta si están indexados |
| Actualización | Requiere reentrenar o ajustar el modelo | Se actualizan los documentos y el índice |
| Fuentes comprobables | Normalmente no | Posible, según cómo esté construido el sistema |
| Errores | Puede inventar datos | Reduce el riesgo, pero no lo elimina |
Un RAG no convierte a un modelo pequeño en uno más inteligente: le da acceso a información pertinente cuando la necesita.
Cómo funciona RAG en IA: paso a paso
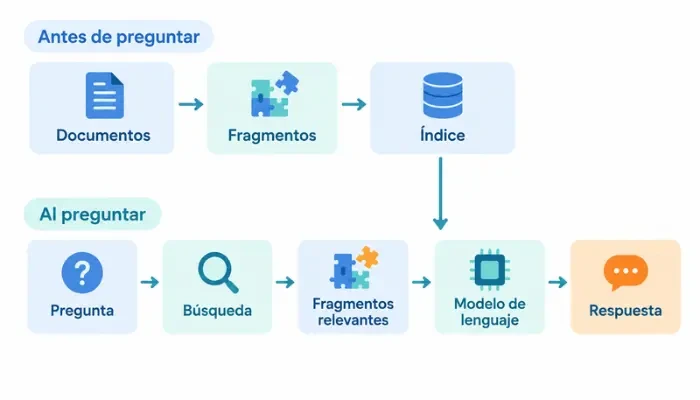
Un RAG funciona en tres fases: dividir los documentos en fragmentos, buscar los fragmentos relevantes para la pregunta y generar la respuesta con ellos. La primera fase se realiza antes de preguntar. Las otras dos se repiten con cada pregunta.
| Fase | Cuándo ocurre | Qué ocurre | Resultado |
| Preparación | Antes de preguntar | Los documentos se dividen en fragmentos y se indexan | Un índice listo para buscar |
| Recuperación | Al preguntar | La pregunta se compara con los fragmentos | Los fragmentos más relevantes |
| Generación | Al preguntar | El modelo recibe la pregunta y esos fragmentos | Una respuesta redactada |
Paso 1: tus documentos se dividen en fragmentos
En el primer paso, el sistema divide tus documentos en fragmentos pequeños y los prepara para poder buscarlos. Este proceso se conoce en inglés como chunking.
Cada fragmento se convierte en un embedding: una lista de números que representa su significado. Los textos con significado parecido quedan representados con números parecidos. Así se puede buscar por sentido y no solo por palabras exactas.
Los embeddings se guardan en un índice, que suele ser una base de datos vectorial. La preparación se hace una vez y se repite cuando cambian los documentos.
El tamaño de los fragmentos influye en el resultado. Si son demasiado pequeños, pierden contexto. Si son demasiado grandes, mezclan temas distintos. No existe un tamaño único que sirva para todos los documentos.
Paso 2: el sistema busca los fragmentos que responden a tu pregunta
En el segundo paso, el sistema convierte tu pregunta en un embedding y busca los fragmentos más parecidos en significado. Después selecciona un número limitado de ellos.
Esta fase se llama recuperación y da nombre a la «R» de RAG. Su calidad condiciona todo lo demás: el modelo solo puede usar los fragmentos que recibe.
Algunos sistemas combinan la búsqueda por significado con la búsqueda por palabras clave. No todos los RAG usan una base de datos vectorial, porque la recuperación admite otros métodos.
Paso 3: el modelo redacta la respuesta con esos fragmentos
En el tercer paso, el sistema entrega al modelo de lenguaje tu pregunta junto con los fragmentos recuperados, y el modelo redacta la respuesta a partir de ese texto. Esta fase corresponde a la «G» de RAG, de Generation.
El modelo no recibe necesariamente todo el documento, sino una selección de fragmentos. Por eso recuperar la información correcta es tan importante como generar bien el texto.
Según cómo esté construido el sistema, la respuesta puede indicar qué fragmentos se han usado. También puede avisar cuando los documentos no contienen información suficiente. Estas funciones dependen de la configuración y no están presentes en todos los RAG.
Un ejemplo de principio a fin
El siguiente ejemplo hipotético recorre las tres fases con un manual interno ficticio.
- Preparación: el manual se divide en fragmentos. Uno corresponde al apartado «Vacaciones» y otro al de «Permisos retribuidos».
- Pregunta: un empleado escribe «¿Cuántos días de vacaciones me corresponden?».
- Recuperación: el sistema compara la pregunta con todos los fragmentos y selecciona los dos apartados más relacionados.
- Generación: el modelo recibe la pregunta y esos dos fragmentos.
- Respuesta: el modelo indica el número de días que figura en el apartado «Vacaciones» y señala que los permisos retribuidos se regulan en otro apartado.
Si la respuesta final es incorrecta, el fallo suele estar en uno de los tres pasos:
| Fase | Fallo habitual | Efecto en la respuesta |
| Preparación | Documentos mal leídos o fragmentos mal divididos | La información relevante queda cortada o ausente |
| Recuperación | Se seleccionan fragmentos poco relacionados con la pregunta | El modelo responde con información que no corresponde |
| Generación | El modelo interpreta mal los fragmentos | La respuesta no refleja fielmente el texto |

 Descargar gratis ahora
Para qué sirve un RAG: beneficios
En IA, un RAG sirve para que un modelo responda a partir de documentos concretos y actualizables, en lugar de depender solo de su entrenamiento. Sus beneficios principales son cuatro, y cada uno tiene una condición para cumplirse.
| Beneficio | Qué aporta | Condición necesaria |
| Respuestas basadas en tus archivos | El modelo usa información que no estaba en su entrenamiento | Los documentos contienen la respuesta |
| Información al día | Se actualiza cambiando los documentos, no el modelo | Los documentos modificados se vuelven a indexar |
| Fuentes comprobables | Se puede ver de dónde procede la respuesta | El sistema está configurado para mostrar las fuentes |
| Mejor búsqueda | Se encuentra la información por su significado | Los documentos están bien preparados |
Respuestas basadas en tus propios archivos
Un RAG permite que el modelo responda con información de tus documentos, aunque esos documentos no formaran parte de su entrenamiento. Pueden ser manuales, informes, apuntes o notas internas.
En el ejemplo del manual, la respuesta sobre las vacaciones procede del propio manual y no de una cifra general. Si el documento no contiene la información, el sistema no puede basarse en él para responder.
Si tus archivos incluyen datos personales, legales, médicos o financieros, conviene saber dónde se procesan antes de usarlos. La sección sobre RAG local y RAG en la nube trata este punto.
Información al día sin reentrenar el modelo
Un RAG mantiene la información al día modificando los documentos, sin necesidad de reentrenar el modelo. Basta con añadir o sustituir los archivos y volver a indexarlos.
- El modelo no cambia. Solo cambia el contenido que puede consultar.
- Las modificaciones se reflejan cuando el índice se actualiza.
- Tú decides qué documentos puede consultar el sistema.
La respuesta solo será tan actual como los documentos. Si el manual está desactualizado, la respuesta también lo estará.
Fuentes que puedes comprobar
Un RAG puede indicar de qué fragmentos procede la respuesta, lo que permite contrastarla con el documento original. Esta función depende de cómo esté construido el sistema y no está presente en todos.
En el ejemplo, la respuesta podría señalar «Manual interno, apartado Vacaciones». Con esa referencia, el empleado abre el apartado y comprueba el texto.
Comprobar la fuente es especialmente recomendable en documentos legales, médicos o financieros.
Mejorar la búsqueda con RAG
Mejorar la búsqueda con RAG significa encontrar la información por su significado y entregar una respuesta redactada, no solo una lista de archivos. Un buscador tradicional compara palabras. Un RAG compara también el sentido de la pregunta y el de los fragmentos.
| Aspecto | Búsqueda por palabras clave | RAG |
| Cómo encuentra | Busca coincidencias de palabras | Busca fragmentos con significado parecido |
| Qué devuelve | Una lista de documentos o páginas | Una respuesta redactada a partir de los fragmentos |
| Cuándo falla | Si la pregunta usa otras palabras que el documento | Si el fragmento adecuado no se recupera |
Ejemplo hipotético:
Un empleado pregunta «¿Puedo coger días libres en agosto?», pero el manual habla de «periodo vacacional». Una búsqueda por palabras clave puede no relacionar ambos términos. Un RAG tiene más posibilidades de hacerlo porque compara significados.
Algunos sistemas combinan ambos tipos de búsqueda.
Qué no hace un RAG
Un RAG no garantiza que la respuesta sea correcta: reduce el riesgo de respuestas inventadas, pero no lo elimina. Las limitaciones principales son estas:
| Limitación | Por qué ocurre | Qué conviene hacer |
| No garantiza la exactitud | El modelo puede interpretar mal los fragmentos | Contrastar con la fuente en decisiones importantes |
| Depende de los documentos | Si están desactualizados, contradictorios o mal escaneados, la respuesta lo refleja | Revisar y ordenar los archivos antes de usarlos |
| Puede no encontrar el fragmento adecuado | La recuperación puede fallar con preguntas ambiguas | Reformular la pregunta con más detalle |
| Procesa una cantidad limitada de texto | El modelo recibe solo algunos fragmentos por consulta | Hacer preguntas concretas |
| No sustituye el criterio profesional | Los documentos legales, médicos o financieros requieren revisión experta | Consultar a un profesional cualificado |
RAG con documentos propios
Un RAG con documentos propios permite hacer preguntas en lenguaje natural sobre tus archivos y recibir respuestas basadas en su contenido. Funciona con las mismas tres fases que cualquier RAG. La diferencia es que las fuentes son tus manuales, informes o notas.
Por qué no basta con pegar el archivo en el chat
Pegar un archivo en el chat funciona con textos cortos, pero resulta poco práctico con documentos largos o numerosos. El motivo es que cada modelo procesa una cantidad limitada de texto por consulta. Ese límite se llama ventana de contexto y varía según el modelo.
Aunque algunos modelos admiten textos muy largos, incluir todo el contenido en cada consulta no siempre es eficiente. Tampoco garantiza que la respuesta sea más precisa.
| Situación | Pegar el texto en el chat | RAG con documentos propios |
| Un documento corto | Suele bastar | No es necesario |
| Un documento largo | Puede superar el límite del modelo o diluir lo relevante | Recupera solo los fragmentos relacionados con la pregunta |
| Muchos archivos | Hay que incluirlos en cada conversación | Se indexan una vez y se consultan juntos |
| Consultas repetidas | Hay que volver a pegar el contenido | El índice se reutiliza |
Las opciones concretas dependen de la herramienta y del modelo que uses.
Qué ocurre cuando preguntas a un RAG sobre tus documentos
Cuando haces una pregunta, el RAG busca en tu índice los fragmentos más relacionados y los usa como base para la respuesta. Tus documentos originales no se modifican.
- Escribes la pregunta en lenguaje natural.
- El sistema recupera los fragmentos más relevantes de tu índice.
- El modelo redacta la respuesta a partir de esos fragmentos.
Hay tres precisiones útiles:
- En un RAG estándar, el modelo no aprende tus documentos de forma permanente. Los consulta en cada pregunta.
- El sistema solo conoce los archivos que has añadido al índice.
- Si añades, cambias o eliminas archivos, el índice debe actualizarse para reflejarlo.
Si tus documentos contienen datos sensibles, comprueba antes dónde se procesan y si se almacenan. La sección sobre RAG local y RAG en la nube explica esta diferencia.
Ejemplo: la misma pregunta con y sin RAG
La misma pregunta puede recibir respuestas distintas con y sin RAG, porque cambia la información que el modelo tiene delante. El ejemplo es hipotético y usa un manual interno ficticio.
Pregunta: «¿Cuántos días de vacaciones me corresponden?»
| Aspecto | Sin RAG | Con RAG |
| Información disponible | Solo el entrenamiento del modelo | El entrenamiento y los fragmentos del manual |
| Respuesta posible | Una explicación general sobre vacaciones, sin relación con el manual | Una respuesta basada en el apartado «Vacaciones» del manual |
| Riesgo principal | Dar información que no corresponde a la empresa | Dar una respuesta incompleta si no se recupera el fragmento adecuado |
| Cómo comprobarla | No hay una fuente concreta que consultar | Abrir el apartado indicado, si el sistema muestra las fuentes |
Cuándo usar un RAG: casos de uso
Conviene usar un RAG cuando necesitas respuestas basadas en documentos concretos, extensos o que cambian con frecuencia. Si el texto es corto y la consulta es puntual, pegarlo en el chat suele bastar.
| Situación | ¿Conviene un RAG? | Motivo |
| Manual o política interna extensa | Sí | Muchas consultas repetidas sobre el mismo contenido |
| Atención al cliente con documentación propia | Sí | Las respuestas se basan en la información vigente |
| Contratos y documentos delicados | Con precaución | Ayuda a localizar información, pero requiere revisión humana |
| Estudio e investigación | Sí | Permite consultar muchos textos a la vez |
| Notas y archivos personales | Depende | Resulta útil cuando son demasiado numerosos para revisarlos a mano |
| Un texto corto y puntual | No es necesario | Basta con pegarlo en el chat |
Manuales, políticas internas y atención al cliente
Un RAG resulta útil con manuales, políticas internas y bases de conocimiento que varias personas consultan con frecuencia. En estos casos, las mismas preguntas se repiten y las respuestas están en documentos que ya existen.
Ejemplo hipotético: un equipo de atención al cliente indexa su guía de devoluciones y consulta el plazo que corresponde a cada tipo de producto.
Hay dos condiciones para que funcione bien:
- La documentación debe estar actualizada y revisada.
- Cuando un documento cambia, el índice debe actualizarse.
Contratos y documentos delicados: ayuda para localizar, no para decidir
Con contratos y otros documentos delicados, un RAG sirve para localizar cláusulas o datos, pero no para tomar decisiones. La revisión y la decisión final corresponden a una persona.
- Qué puede hacer: encontrar el apartado que trata un tema, como la renovación o los plazos de preaviso, y mostrar el texto relacionado.
- Qué no puede hacer: garantizar que no omite una cláusula relevante ni interpretar sus efectos legales.
- Qué conviene hacer: contrastar siempre con el documento original y consultar a un profesional cualificado en decisiones importantes.
Antes de usar documentos legales, médicos o financieros, comprueba dónde se procesan, si se almacenan y quién puede acceder a ellos. Si contienen datos personales, valora si necesitas protegerlos o eliminarlos primero.
Estudio e investigación
En estudio e investigación, un RAG permite consultar muchos textos a la vez y localizar los pasajes relacionados con una pregunta. Los textos pueden ser artículos, apuntes o informes.
Ejemplo hipotético: un estudiante indexa los apuntes de un curso y pregunta en qué apartado se explica un concepto concreto.
La calidad de la respuesta depende de la calidad de las fuentes. Si vas a citar un dato, compruébalo en el texto original. Un RAG facilita la consulta, pero no sustituye la lectura crítica.
Notas y archivos personales
Un RAG también sirve para consultar notas, apuntes y archivos personales cuando son demasiado numerosos para revisarlos a mano. Por ejemplo, actas de reuniones, listas de tareas o ideas guardadas durante años.
Funciona mejor con notas ordenadas y con títulos claros. Los archivos personales pueden incluir datos sensibles, por lo que conviene comprobar cómo y dónde se procesan antes de añadirlos.
Cuándo no necesitas un RAG
No necesitas un RAG cuando el texto es corto, la consulta es puntual o la respuesta no depende de tus documentos. En esos casos, un modelo de lenguaje normal es suficiente.
- Documento corto: si cabe en el chat, pégalo directamente.
- Pregunta general: una duda que no depende de tus archivos se responde sin consultarlos.
- Lectura completa: para resumir un PDF con IA de principio a fin, un RAG puede funcionar peor, porque trabaja con fragmentos y puede dejar partes fuera.
- Documentos sin preparar: si los archivos están desordenados o son ilegibles, conviene prepararlos antes. La sección sobre preparación de documentos explica cómo hacerlo.

 Resumir mi PDF gratis
Cómo preparar documentos para RAG
Para preparar documentos para RAG conviene usar archivos legibles, eliminar duplicados y versiones antiguas, ordenarlos por temas y revisar los datos sensibles. Cuanto más limpios estén los documentos, más probable es que el sistema recupere los fragmentos correctos.
Elige formatos que el sistema pueda leer
Un RAG necesita texto que pueda leer, por lo que los archivos con texto seleccionable funcionan mejor que las imágenes de texto. Los escaneos requieren un paso previo de OCR.
| Tipo de archivo | Cómo se lee | Qué conviene hacer |
| PDF con texto seleccionable | Se lee directamente | Comprobar que el texto se copia correctamente |
| PDF escaneado o imagen | Requiere OCR | Aplicar OCR y revisar el resultado |
| Word, TXT, Markdown | Texto directo | Comprobar que los títulos y la estructura son claros |
| Excel y CSV | Datos en tablas | Incluir encabezados claros en cada columna |
| Presentaciones | Texto de las diapositivas | El texto dentro de imágenes puede requerir OCR |
El OCR (reconocimiento óptico de caracteres) convierte el texto de una imagen en texto editable. Puede cometer errores con escaneos de baja calidad, tablas o letra manuscrita, por lo que conviene revisar el resultado.
Los formatos exactos que admite un sistema RAG dependen de cada herramienta. iBoomto AI admite los formatos de documento habituales, como PDF, Word, Excel, PowerPoint, CSV y mapas mentales. También procesa archivos Markdown, texto plano (TXT), imágenes, direcciones web y carpetas completas. Además, incluye OCR integrado.
Elimina duplicados y versiones antiguas
Los duplicados y las versiones antiguas pueden hacer que un RAG recupere información contradictoria o desactualizada. Si hay dos versiones de un mismo documento, el sistema puede usar fragmentos de ambas.
- Conserva solo la versión vigente de cada documento.
- Guarda el historial fuera de la carpeta que vas a indexar.
- Incluye la fecha o la versión en el nombre del archivo.
Ejemplo hipotético: si un manual antiguo indica 22 días de vacaciones y el nuevo indica 23, la respuesta puede depender de qué fragmento recupere el sistema.
Divide por temas y usa nombres claros
Los documentos organizados por temas y con títulos claros facilitan que el sistema encuentre el fragmento adecuado. El sistema ya divide el texto en fragmentos, pero una estructura clara ayuda a que cada fragmento tenga sentido por sí mismo.
| Práctica | Ejemplo menos útil | Ejemplo más útil |
| Nombre del archivo | documento_final_v3.pdf | politica-vacaciones.pdf |
| Organización | Un archivo con varios temas sin relación | Un archivo por tema cuando sea posible |
| Títulos internos | Texto continuo sin apartados | Títulos y subtítulos que describen cada apartado |
Revisa los datos sensibles antes de empezar
Antes de añadir archivos a un RAG, revisa si contienen datos personales, confidenciales o sujetos a restricciones. Este paso es especialmente importante con documentos legales, médicos o financieros.
- Identifica los datos personales, como nombres, direcciones, números de identificación, datos bancarios o de salud.
- Decide si son necesarios para lo que quieres consultar. Elimina o anonimiza los que no lo sean.
- Comprueba dónde se procesan los documentos y si el contenido se almacena.
- Verifica quién tiene acceso a los archivos y a las respuestas.
Lista rápida de comprobación
Esta lista resume los puntos anteriores y sirve como revisión final antes de indexar tus documentos.
- Los archivos tienen texto legible o se han procesado con OCR.
- El resultado del OCR se ha revisado.
- No hay duplicados ni versiones antiguas.
- Cada archivo tiene un nombre claro y, si es posible, trata un solo tema.
- Los títulos internos describen cada apartado.
- Los datos sensibles innecesarios se han eliminado o anonimizado.
- Sabes dónde se procesan los documentos y quién puede acceder a ellos.
RAG local frente a RAG en la nube: cuál es la diferencia
La diferencia principal entre un RAG local y uno en la nube es dónde se ejecutan el modelo y el índice: en tu propio equipo o en los servidores de un proveedor. De esa diferencia se derivan las demás: privacidad, hardware, coste y mantenimiento.
| Aspecto | RAG local | RAG en la nube |
| Dónde se procesan los documentos | En tu ordenador o en tu propio servidor | En los servidores del proveedor del servicio |
| Hardware | Depende de tu equipo | No requiere un equipo potente |
| Tamaño del modelo | Limitado por tu hardware | Acceso habitual a modelos grandes |
| Velocidad | Depende de tu equipo | Depende del servicio y de la conexión |
| Coste | Normalmente sin cuota por uso; el equipo asume el consumo de recursos | Suele cobrarse por uso o por suscripción |
| Mantenimiento | Lo gestionas tú: modelos, índice y actualizaciones | Lo gestiona el proveedor |
| Control de los datos | Tú decides dónde se guardan | Sujeto a las condiciones del proveedor |
Dónde se procesan tus documentos
En un RAG local, los documentos se procesan en tu propio equipo; en un RAG en la nube, se envían a los servidores del proveedor. Cada opción plantea preguntas distintas que conviene revisar, sin que una sea mejor que la otra en todos los casos.
Existen configuraciones mixtas. Por ejemplo, un índice almacenado en local con un modelo que se ejecuta en la nube. Por eso conviene comprobar qué parte del sistema se ejecuta en cada lugar.
Hardware, velocidad y tamaño del modelo
Un RAG local depende de la potencia de tu equipo, mientras que uno en la nube no la necesita. Esto condiciona qué modelos puedes usar y a qué velocidad responden.
- Memoria y procesador: los modelos más grandes necesitan más recursos. Si tu equipo no los tiene, tendrás que usar modelos más pequeños.
- Calidad de las respuestas: en algunas tareas, un modelo pequeño puede rendir peor que uno grande.
- Velocidad: en local depende de tu equipo. En la nube, del servicio y de la conexión.
- Ventana de contexto: cada modelo tiene la suya, tanto en local como en la nube. Es un límite del modelo, no una cuota de uso.
Cómo se paga: por uso o con tu propio equipo
En la nube se suele pagar por uso o por suscripción, mientras que en local normalmente no hay una cuota por uso. El equipo asume el consumo de recursos, como electricidad y capacidad de cálculo.
Muchos servicios en la nube miden el uso en tokens, que son fragmentos de texto procesados por el modelo. Cuanto más texto se procesa, mayor es el consumo. Con un modelo local, ese consumo no se factura, pero el modelo sigue teniendo su propia ventana de contexto.
Cuál encaja contigo
La opción que mejor encaja depende de tus documentos, de tu equipo y de la frecuencia de uso. No existe una opción válida para todos los casos.
| Situación | Opción que suele encajar |
| Documentos delicados que quieres mantener bajo tu control | RAG local |
| Equipo con pocos recursos | RAG en la nube |
| Uso ocasional y puntual | RAG en la nube |
| Uso frecuente con muchos documentos | RAG local, si tu equipo lo permite |
| Necesitas el modelo más grande disponible | RAG en la nube |
Antes de procesar archivos sensibles
Antes de procesar archivos legales, médicos o financieros, comprueba qué parte del sistema ejecuta cada tarea y qué ocurre con tus datos. Estas preguntas sirven para ambas opciones.
- ¿Dónde se ejecutan el modelo y el índice?
- ¿Se almacenan los documentos, el índice o las consultas? ¿Durante cuánto tiempo?
- ¿Quién puede acceder a ellos?
- ¿Se utilizan los datos para otros fines, como entrenar modelos?
- ¿Puedes eliminar tus datos cuando quieras?
Si los documentos están sujetos a normativa de protección de datos, consulta con la persona responsable en tu organización antes de usarlos.
Cómo usar RAG con tus documentos en iBoomto AI
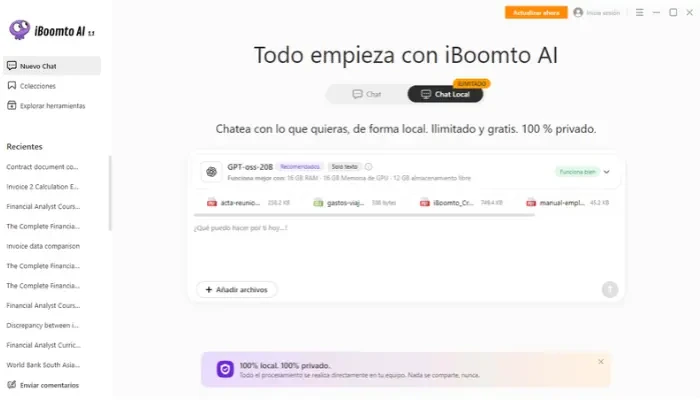
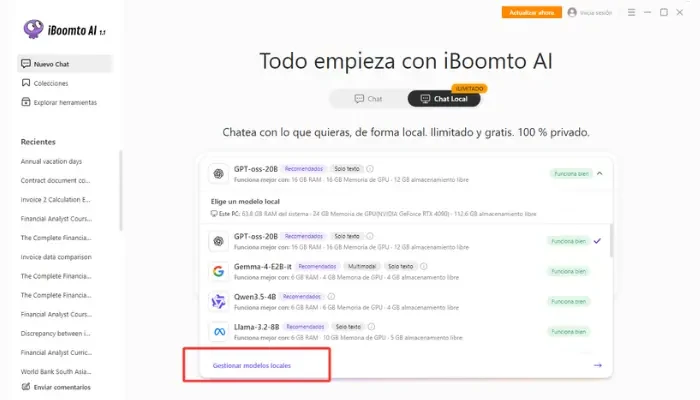
En iBoomto AI puedes hacer preguntas sobre tus documentos en la pestaña Chat Local: añades los archivos, eliges un modelo y escribes la pregunta. El sistema consulta los archivos añadidos antes de responder.
Qué es iBoomto AI y cómo trabaja con tus archivos
iBoomto AI es un software local. Su pestaña Chat Local permite hacer preguntas sobre tus archivos con modelos de lenguaje que se ejecutan en tu propio equipo.
características principales
- Chat Local: usa modelos de lenguaje locales para responder a tus preguntas.
- Modelos descargables: se descargan desde el propio programa: Qwen, Gemma 4, DeepSeek, LLaMA y OpenAI, en distintas versiones.
- Sin límite de tokens: el uso no se limita por tokens. La ventana de contexto sigue siendo un límite propio de cada modelo.
- Formatos habituales y OCR: admite PDF, Word, Excel, PowerPoint, CSV y otros formatos, e incluye OCR integrado.
Los modelos más grandes necesitan más memoria. Conviene elegir la versión que tu equipo pueda ejecutar con soltura.
Flujo de trabajo paso a paso
El flujo consta de cinco pasos: abrir Chat Local, elegir un modelo, añadir los archivos, escribir la pregunta y comprobar la respuesta.
Paso 1. Selecciona la pestaña Chat Local.
Paso 2. Elige un modelo. Si todavía no tienes ninguno, descárgalo desde el propio programa.
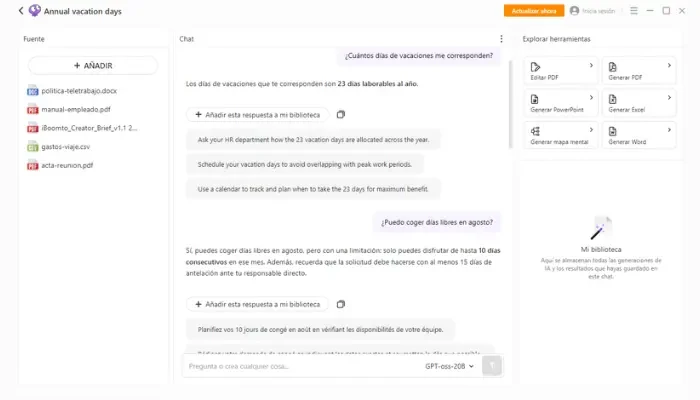
Paso 3. Pulsa Añadir archivos y selecciona los documentos que quieres consultar.
Paso 4. Escribe tu pregunta en el chat, en lenguaje natural.
Paso 5. Comprueba la respuesta con el documento original, sobre todo si se trata de datos importantes.
Consejo:
Si la respuesta no parece corresponder al documento esperado, indicar el nombre del archivo en la pregunta puede ayudar a orientar la búsqueda.
Ejemplo de una prueba real:
La prueba se hizo en Chat Local con documentos de ejemplo creados para esta guía: un manual del empleado (PDF), una política de teletrabajo (Word), una tabla de gastos de viaje (CSV) y un acta de reunión escaneada (PDF). La empresa del ejemplo es ficticia.
- Modelo: GPT-oss-20B.
- Equipo: 63,8 GB de RAM del sistema y 24 GB de memoria de GPU (NVIDIA GeForce RTX 4090).
| Pregunta | Documento consultado | Respuesta del sistema |
| ¿Cuántos días de vacaciones me corresponden? | Manual del empleado (PDF) | 23 días laborables al año |
| ¿Puedo coger días libres en agosto? | Manual del empleado (PDF) | Sí, con un máximo de 10 días consecutivos y solicitud con 15 días de antelación |
| ¿Cuántos días puedo teletrabajar y hay algún día obligatorio en la oficina? | Política de teletrabajo (Word) | Hasta 2 días por semana; el martes es obligatorio en la oficina |
| ¿Qué se decidió sobre el presupuesto de formación en la reunión del 14 de marzo? | Acta escaneada (PDF) | Se aprobó un presupuesto de formación de 3.000 € para el segundo trimestre |
| ¿Qué seguro médico ofrece la empresa? | Ninguno contiene esa información | El sistema indicó que los documentos no mencionan un seguro médico |
La segunda pregunta usa «días libres», mientras que el manual dice «periodo vacacional»: el sistema relacionó ambos términos. La cuarta pregunta se responde a partir de un documento escaneado, lo que requiere OCR. En la última, no había información disponible y el sistema lo indicó.
Esta prueba usa cuatro documentos cortos y una sola configuración. Estos resultados son orientativos, no una comparación independiente entre herramientas. Con documentos más largos o preguntas más ambiguas, los resultados pueden variar. Un equipo con menos recursos también puede afectar a la velocidad y a los modelos que se pueden utilizar.
Preguntas frecuentes
Conclusión
Qué es un RAG, en resumen: un sistema que busca en tus documentos antes de que un modelo de IA responda. Divide los archivos en fragmentos, localiza los más relevantes para tu pregunta y genera la respuesta a partir de ellos. Reduce el riesgo de respuestas inventadas, pero no lo elimina, por lo que conviene contrastar los datos importantes con la fuente.
Si tu equipo puede ejecutar modelos locales y la privacidad de tus documentos es una prioridad, iBoomto AI es una opción muy adecuada: en su pestaña Chat Local, los modelos se ejecutan en tu propio equipo.
¿Te resultó útil este artículo?
¡Gracias por tus comentarios!