
¿Qué es un LLM? Funcionamiento, usos y ejemplos
- ¿Qué es un LLM y en qué se diferencia de la IA en particular?
- ¿Cómo funciona un LLM?
- ¿Para qué sirve un LLM?
- Tipos de LLM: clasificación según despliegue, licencia y tamaño
- LLM local vs. LLM en la nube
- Preguntas Frecuentes sobre los modelos de lenguaje
- Conclusiones
Seguro que has usado ChatGPT, Claude o Gemini para resumir un texto o redactar un correo, pero ¿sabes qué hay detrás? Estas herramientas de IA se basan en los grandes modelos de lenguaje, conocidos como LLM (large language models): un tipo de inteligencia artificial entrenado con enormes cantidades de texto para entender y generar lenguaje humano.
En esta guía verás qué es un LLM, cómo funciona, para qué sirve, qué tipos existen y cuándo conviene ejecutarlo en tu propio equipo en lugar de en la nube, sobre todo si trabajas con documentos confidenciales.
¿Qué es un LLM y en qué se diferencia de la IA en particular?
El término LLM deriva del inglés Large Language Model («gran modelo de lenguaje»), y cada palabra da una pista: es un modelo grande, porque se entrena con enormes cantidades de texto y suele tener miles de millones de parámetros; de lenguaje, porque trabaja con texto escrito; y un modelo, es decir, un sistema matemático que aprende patrones a partir de datos.
Un ejemplo lo hace más claro: le pides a la IA que te explique la hipoteca como si tuvieras 12 años; luego recibes una explicación sencilla con ejemplos. Nadie escribió esa respuesta de antemano: el LLM la genera paso a paso, prediciendo qué texto encaja mejor con tu petición. Más adelante vemos cómo funciona.
Importa porque ChatGPT, Gemini o Claude funcionan sobre un LLM y, sin él, no podrían entender tu pregunta ni redactar la respuesta. Pero ¿es lo mismo un LLM que la inteligencia artificial? Lo veremos posteriormente.
¿En qué se diferencia un LLM de la IA en general?
Para aclarar la relación entre la IA y un LLM, los comparamos en cuatro apartados.
| Aspecto | IA | LLM |
|---|---|---|
| Definición | Campo que crea sistemas capaces de aprender, percibir, razonar y decidir. | Modelo de lenguaje entrenado con grandes volúmenes de texto para aprender patrones del lenguaje para procesar y generar texto según el contexto. |
| Ámbito | Amplio: abarca distintas funciones y aplicaciones, incluidos el aprendizaje automático, la visión por ordenador, la robótica y más. | Específico: se especializa en el procesamiento del lenguaje natural, aunque sus aplicaciones van más allá del texto. |
| Funciones | Clasificar, predecir, reconocer imágenes o voz, generar imágenes o vídeos, automatizar. | Redactar texto, resumir documentos, traducir, responder preguntas, programar. |
| Ejemplos | ChatGPT, Gemini, Claude | GPT, Deepseek, Llama |
Nota:
¿Y un chatbot? Un chatbot es la aplicación con la que se conversa, y el LLM es el modelo que hay detrás. Por ejemplo, ChatGPT es un chatbot y GPT es el LLM que lo impulsa. Además, no todos los chatbots usan un LLM: los más antiguos seguían reglas predefinidas.
En resumen, todos los LLMs forman parte de la IA, pero no todos los sistemas de IA son LLMs.
¿Cómo funciona un LLM?
Un LLM funciona en dos fases: primero se entrena para aprender cómo se usa el lenguaje; y después, genera respuestas token a token. A continuación, veamos cada fase.
Entrenamiento del modelo
En la fase de preentrenamiento, el modelo lee grandes cantidades de texto (libros, artículos, páginas web, código) e intenta predecir el siguiente token, es decir, el siguiente fragmento de texto. Cada vez que falla, ajusta sus parámetros para aprender mejor los patrones de lenguaje. Tras millones de repeticiones, consigue dominar la gramática, el estilo y el conocimiento general. Más allá de eso, el modelo se perfecciona con dos técnicas:
- Ajuste fino: un entrenamiento adicional con ejemplos de instrucciones y respuestas, para que el LLM aprenda a seguir lo que le pides.
- RLHF (aprendizaje por refuerzo con retroalimentación humana): las personas valoran distintas respuestas y el modelo se ajusta para satisfacer mejor sus necesidades.
¿Cómo genera respuestas un LLM?
Cuando le haces una pregunta a un LLM, la respuesta aparece en cuestión de segundos. Pero el proceso se puede resumir en cuatro pasos.
- Convierte el texto en tokens.
¿Qué es un token? Un token es la unidad de texto que procesa un LLM: puede ser una palabra completa, una parte de una palabra, un signo de puntuación, un número o una combinación de caracteres. Por ejemplo, «perro» puede ser un solo token, mientras que una palabra larga como «extraordinario» podría dividirse en varios tokens (la división real depende de cada modelo). Cuando escribes una pregunta, el modelo la divide en tokens y asigna un número a cada uno, porque trabaja con códigos y no con letras. Este proceso se llama tokenización.
- Analiza el contexto con la arquitectura Transformer
El Transformer es uno de los pilares fundamentales de la mayoría de los LLM actuales. Su mecanismo de atención (self-attention) conecta cada token con los demás para comprender el contexto. Por ejemplo: en «El ratón se escondió debajo de la mesa», la palabra «ratón» se refiere a un animal; en «Necesito un ratón para mi ordenador», se refiere a un dispositivo informático. Así que el contexto ayuda al modelo a identificar ambos significados.
- Tiene en cuenta la ventana de contexto.
La ventana de contexto es la cantidad máxima de tokens que un LLM puede considerar en una conversación. En ese espacio caben tu pregunta, el historial de la conversación y los documentos que subes. Puedes imaginarla como la memoria a corto plazo del LLM. Como el espacio es limitado, cuando se agota la ventana, el modelo debe descartar o resumir lo más antiguo, lo que puede hacer que pierda detalles importantes o responda con menos precisión.
- Predice el siguiente token y genera la respuesta.
Calcula la probabilidad de cada token posible y elige uno. Un ejemplo: con «la capital de España es», lo más probable es «Madrid». Después añade ese token al texto y repite el proceso, uno a uno, hasta completar la respuesta. No escribe todo de una vez.
En definitiva, un LLM no nace sabiendo generar respuestas: aprende los patrones de lenguaje durante el entrenamiento, con grandes cantidades de texto, el ajuste fino y el RLHF. Después, para responder a tu pregunta, divide tu texto en tokens, analiza cómo se relacionan gracias al Transformer, tiene en cuenta todo lo que cabe en su ventana de contexto y predice la respuesta token a token.
Ten en cuenta sus límites (los ampliamos más adelante):
- Solo conoce lo que aprendió durante el entrenamiento.
- Su ventana de contexto es limitada.
- Genera texto plausible, pero no comprueba que sea cierto.
¿Para qué sirve un LLM?
Ya sabemos qué es un LLM y cómo funciona; ahora toca ver sus usos habituales, ventajas y limitaciones.
Usos habituales:
- Escribir y revisar código: es habitual que quienes programan lo utilicen para generar código, explicar un fragmento o encontrar un error.
- Redactar textos: a partir de notas o frases, se puede preparar el borrador de un correo, un informe o un artículo que se adapte a tus necesidades.
- Editar y corregir el estilo: corrige errores presentes, mejora la claridad del texto y adapta el tono que buscas.
- Traducir entre idiomas: traduce los documentos a otros idiomas respetando el sentido y el tono originales.
- Resumir documentos largos: sintetiza un documento de 30 páginas en sus puntos clave.
Ventajas y limitaciones de un LLM
Ventajas de LLM:
- Comprender el lenguaje natural: entiende instrucciones escritas como dirías, sin comandos ni palabras clave especiales. Por ejemplo, puedes escribir «dame un plan de estudio para aprender inglés» y entenderé lo que quieres, incluso si lo dices de forma imprecisa.
- Versatilidad: al usar un LLM, no necesitas cambiar de programa ni volver a configurarlo: solo cambias la instrucción. En la misma conversación puedes pedirle que traduzca un texto, lo resuma y redacte un borrador de correo con las indicaciones (prompts).
- Ahorrar tiempo: puede generar un borrador según tus requisitos; solo necesitas revisarlo y ajustarlo.
Limitaciones de LLM:
- Alucinación: es posible generar respuestas incorrectas o inventadas que parecen convincentes. Por eso conviene verificar siempre los datos importantes, especialmente las cifras, las citas y las referencias.
- Privacidad de los datos: con un LLM en la nube, lo que escribes o subes viaja a servidores externos para procesarse. Si se trata de información confidencial, puede ser un problema; de hecho, es una de las razones por las que existe un LLM local.
- Sesgo del modelo: puede reproducir los sesgos presentes en los datos de entrenamiento y generar respuestas estereotipadas. Conviene leerlo con ojos críticos.
Tipos de LLM: clasificación según despliegue, licencia y tamaño
| Criterio | Tipos | Qué significa | Ejemplos |
|---|---|---|---|
| Despliegue | Local, nube, híbrido | Indica dónde se ejecuta el modelo y quién controla los datos. |
LLM en la nube: GPT, Gemini, Claude LLM local: Llama, Deepseek |
| Licencia | Código abierto, propietario | Indica quién puede utilizar, modificar y alojar el modelo y qué usos permite su licencia. |
De código abierto: Llama, Mistral, Deepseek. Propietarios: Claude, GPT |
| Tamaño | Pequeño, mediano, grande | Se basa en la cantidad de parámetros. Los modelos grandes suelen tener más capacidad, pero exigen más recursos al dispositivo; los pequeños consumen menos y son adecuados para tareas sencillas y específicas. | Los LLM como Gemma y Qwen ofrecen versiones pequeñas (para un portátil) y grandes (para servidores). |
Nota:
Gemma 3, por ejemplo, tiene versiones de 1.000 millones y de 27.000 millones de parámetros. Los modelos más grandes suelen requerir más recursos para funcionar, aunque un mayor número de parámetros no garantiza mejores resultados en todas las tareas.
Ejemplos prácticos de LLM
Un mismo modelo puede combinar varios tipos a la vez. Estos tres ejemplos conocidos lo demuestran:
- GPT (OpenAI): propietario y en la nube. Lo usas a través de ChatGPT o de una API, sin acceso a su funcionamiento interno.
- Llama (Meta): de código abierto y local, por lo que puedes descargarlo y ejecutarlo en tu propio equipo. Existe en varios tamaños, desde los pequeños hasta los muy grandes. Utilizarlo depende de tu hardware.
- Gemma (Google): de código abierto y ligero, se centra en desarrollar versiones pequeñas que pueden funcionar en un portátil.
Si buscas potencia, calidad y empezar rápido, la nube suele ser la mejor opción; si priorizas la privacidad y la seguridad, un modelo local. Lo comparamos en detalle posteriormente.
LLM local vs. LLM en la nube
A continuación comparamos ambos desde seis puntos de vista.
| Criterio | LLM en la nube | LLM local |
|---|---|---|
| Dónde se ejecuta | Servidores del proveedor | Tu equipo o servidor |
| Privacidad | Los datos viajan a un tercero. | Los datos permanecen contigo. |
| Coste | Suscripción o pago por uso (tokens) | Sin cuotas por uso, pero requiere un equipo con capacidad suficiente según el modelo. |
| Capacidad | Suele ofrecer resultados precisos y adaptados a las necesidades de los usuarios. | Puede ofrecer resultados de calidad comparable a los de los modelos en la nube, aunque su rendimiento depende del modelo elegido y de la capacidad del hardware. |
| Conexión a Internet | Sí | No |
| Ideal para | Tareas generales o creativas y trabajo con datos poco sensibles. | Documentos confidenciales, sectores regulados, uso intensivo o trabajo sin conexión. |
Si trabajas con documentos confidenciales, un LLM local es la opción más segura, porque tus datos no salen de tu equipo. Pero tiene un límite que ya conoces: no sabe nada de tus archivos. Para que puedas trabajar con ellos, requiere una técnica llamada RAG.
¿Qué es RAG y cómo permite a un LLM local trabajar con tus documentos?
Un LLM local procesa tus datos en tu equipo, pero por sí solo no conoce tus documentos. Solo sabe lo que aprendió al entrenarse, así que si le preguntas por un documento largo o que no ha visto, puede inventarse una respuesta que parezca convincente. Y aunque pegues el documento en la conversación, es posible que un documento extenso no quepa en la ventana de contexto.
Ahí entra RAG (Retrieval-Augmented Generation, o generación aumentada por recuperación), una técnica que permite al LLM consultar tus documentos antes de responder.
Así funciona RAG con tus documentos:
- Preparar tu documento: el sistema lo divide en fragmentos pequeños y los organiza para poder buscarlos por significado más adelante.
- Buscar lo relevante: ante tu pregunta, localiza los fragmentos relacionados que mejor la responden.
- Entregar esos fragmentos al LLM: el modelo recibe tu pregunta junto con ellos.
- Responder citando la fuente: redacta la respuesta a partir de esas referencias e indica de qué documento procede.
Qué aporta RAG:
- Reducir alucinaciones: responde a partir de fragmentos reales de tus documentos y, si la herramienta cita la fuente, puedes comprobarlo.
- Citar las fuentes: las respuestas se basan en tus archivos y no solo en lo que el modelo aprendió durante el entrenamiento.
- Actualizar la información: basta con añadir o cambiar documentos.
En resumen, un LLM local protege tus datos y RAG le permite trabajar con tus documentos. Herramientas como iBoomto AI reúnen ambas ideas en un solo programa.

Ejemplo práctico: iBoomto AI para procesar documentos en local
Imagina que trabajas en recursos humanos y tienes decenas de expedientes de empleados: contratos, nóminas, evaluaciones y solicitudes de vacaciones. Necesitas saber qué personas tienen vacaciones pendientes este trimestre o preparar un resumen de la trayectoria de un empleado antes de una reunión. Buscarlo a mano lleva horas, y subir esos archivos a un chatbot en la nube no es una mejor opción: contienen datos personales.
iBoomto AI es un agente de IA de escritorio que se conecta con modelos de lenguaje locales (LLM local) para trabajar con documentos y archivos, automatizar tareas y ejecutar flujos de trabajo con mayor control sobre los datos. Permite aprovechar las capacidades de los LLM locales en tareas de productividad documental, sin depender necesariamente de servicios de LLM en la nube.
En este caso, puedes preguntarle qué empleados tienen vacaciones pendientes este trimestre y recibir la respuesta con el documento del que procede, sin que los expedientes salgan de tu equipo.
- Funciones aportadas por iBoomto:
- Resumir documentos: con prompts claros y específicos, puedes obtener un resumen basado en documentos.
- Generar documentos en formato PDF o Word: subir los documentos relevantes con prompts claros; con el tiempo, obtendrás un borrador de lo que buscas.
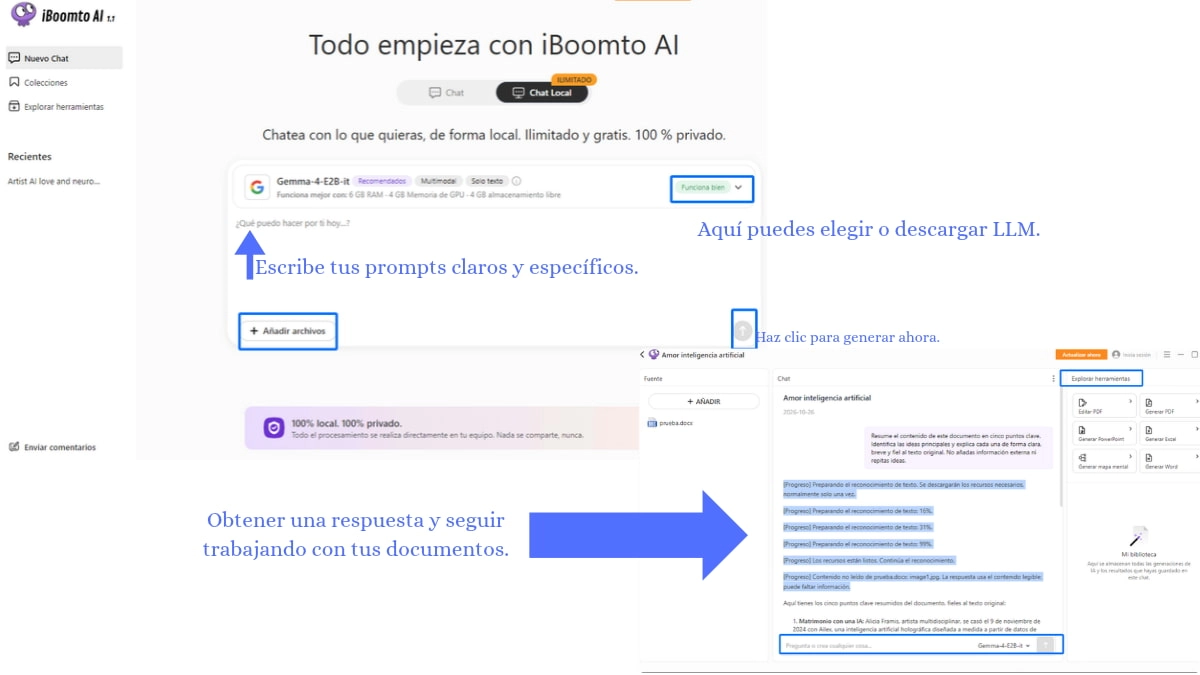
- Requisitos y limitaciones: Para usar un LLM local necesitas un equipo con capacidad suficiente. Como referencia, iBoomto AI funciona en un equipo con procesador Intel Core i3-7100 (3,90 GHz), tarjeta gráfica NVIDIA RTX 3050 de 6 GB y 8 GB de memoria RAM. Es una configuración modesta, pero el resultado depende del modelo que elijas: un modelo pequeño como Gemma-4-E2B-it funciona bien en equipos como este, aunque puede ser menos preciso con documentos largos o complejos.
Preguntas Frecuentes sobre los modelos de lenguaje
Conclusiones
¿Qué es un LLM? Es un modelo de inteligencia artificial que genera lenguaje prediciendo, token a token, la continuación más probable de un texto. Sirve para escribir, resumir, traducir o programar, pero puede equivocarse, no conoce tus documentos y, en la nube, plantea dudas de privacidad. Para aprovecharlo mejor, da instrucciones claras y verifica siempre los datos importantes.
Si trabajas con documentos y quieres que no salgan de tu equipo, un LLM local con RAG es la combinación que resuelve ambos problemas. Puedes ponerlo en marcha con iBoomto LLM local.
¿Te resultó útil este artículo?
¡Gracias por tus comentarios!