
RAG KI: Was ist Retrieval-Augmented Generation und wie funktioniert es?
- Was bedeutet RAG bei KI? Definition und Bedeutung einfach erklärt
- Wie funktioniert ein RAG KI System?
- Wie ist eine RAG-Architektur aufgebaut?
- Welche Vorteile bietet RAG für KI-Systeme?
- RAG vs. Fine-Tuning vs. klassische KI-Suche – was ist der Unterschied?
- Welche Anwendungsfälle gibt es für RAG in Unternehmen?
- Wie lassen sich Qualität, Sicherheit und Kosten eines RAG-Systems bewerten?
- Welche Grenzen und Herausforderungen hat RAG?
- Häufige Fragen zu RAG KI
- Fazit
RAG steht für Retrieval-Augmented Generation und verbindet die Suche nach externen Informationen mit der Textgenerierung durch ein großes Sprachmodell (LLM). Dadurch kann eine KI beispielsweise Unternehmensdokumente, Datenbanken oder aktuelle Wissensquellen nutzen, um Fragen zu beantworten. RAG KI kann die Zuverlässigkeit von KI-Antworten verbessern und Halluzinationen reduzieren, garantiert jedoch keine fehlerfreien Ergebnisse. Entscheidend sind die Qualität der Daten, die Relevanz der Suchergebnisse und die Verarbeitung der gefundenen Informationen.
Was bedeutet RAG bei KI? Definition und Bedeutung einfach erklärt
RAG erweitert generative KI um einen gezielten Informationsabruf. Das System sucht zunächst relevante Inhalte und nutzt sie anschließend als Kontext für die Antwortgenerierung.
Wofür steht die Abkürzung RAG?
- Retrieval: Relevante Informationen aus externen Quellen abrufen.
- Augmented: Den Kontext des Sprachmodells um diese Informationen erweitern.
- Generation: Aus der Frage und den gefundenen Informationen eine Antwort formulieren.
Was ist ein KI RAG und wann wird es eingesetzt?
Die RAG-KI Bedeutung liegt in der Verbindung von Suche und Textgenerierung.
Beispiel: Ein Mitarbeiter fragt nach der aktuellen Reisekostenrichtlinie. Das RAG-System durchsucht die internen Dokumente, findet die passende Regelung und übergibt sie an das Sprachmodell. Dieses formuliert daraus eine Antwort mit einem Verweis auf die Quelle.
Wie funktioniert ein RAG KI System?
Ein RAG KI System verarbeitet Dokumente zunächst für die Suche. Bei einer Anfrage ruft sie passende Informationen ab und übergibt sie an ein Sprachmodell, das daraus eine Antwort erstellt. Die dafür notwendige Aufbereitung von Dokumenten ist auch ein wichtiger Bestandteil der intelligenten Dokumentenverarbeitung.
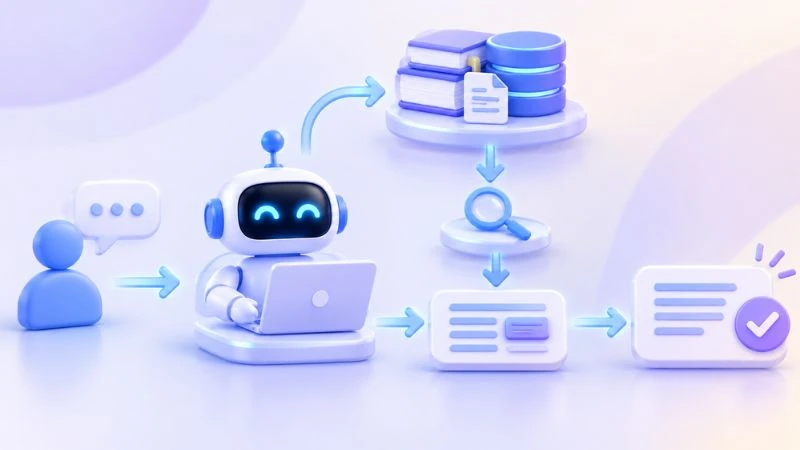
1. Datenquellen vorbereiten und Dokumente aufteilen
- Datenquellen: PDF- und Word-Dateien, Webseiten und Datenbanken einlesen.
- Aufbereitung: Texte bereinigen und in kleinere Abschnitte (Chunks) unterteilen.
- Metadaten: Informationen wie Dokumenttitel, Seitenzahl und Version ergänzen.
2. Embeddings erstellen und Wissen indexieren
- Embeddings: Texte in numerische Vektoren umwandeln, die semantische Eigenschaften abbilden.
- Indexierung: Inhalte für spätere Suchanfragen organisieren.
- Speicherung: Vektordatenbanken oder andere Suchindizes verwenden. Eine Vektordatenbank ist nicht für jedes RAG-System-KI zwingend erforderlich.
3. Relevante Informationen zur Nutzerfrage abrufen
- Semantische Suche: Inhaltlich passende Textabschnitte finden.
- Stichwortsuche: Konkrete Begriffe, Namen oder Versionsnummern suchen.
- Hybride Suche: Beide Verfahren kombinieren und die relevantesten Ergebnisse auswählen.
4. Den Kontext an das Sprachmodell übergeben
- Nutzerfrage: Die ursprüngliche Anfrage berücksichtigen.
- Suchergebnisse: Relevante Textabschnitte als Kontext hinzufügen.
- System Anweisungen: Festlegen, wie die KI mit den Informationen umgehen und auf fehlende Belege reagieren soll.
5. Eine Antwort generieren und Quellen überprüfen
- Generierung: Das Sprachmodell formuliert eine Antwort auf Grundlage des Kontexts.
- Quellenangaben: Verwendete Dokumente oder Textpassagen nach Möglichkeit angeben.
- Qualitätskontrolle: Prüfen, ob die Quellen die Antwort stützen. Bei unzureichenden Informationen sollte das System auf die Wissenslücke hinweisen.
Wie ist eine RAG-Architektur aufgebaut?
Ein RAG-KI-System besteht aus mehreren Komponenten, die gemeinsam für Datenaufbereitung, Informationsabruf und Antwort Generierung sorgen. Je nach Anwendungsfall können zusätzliche Such-, Sicherheits- und Evaluierung Komponenten erforderlich sein.
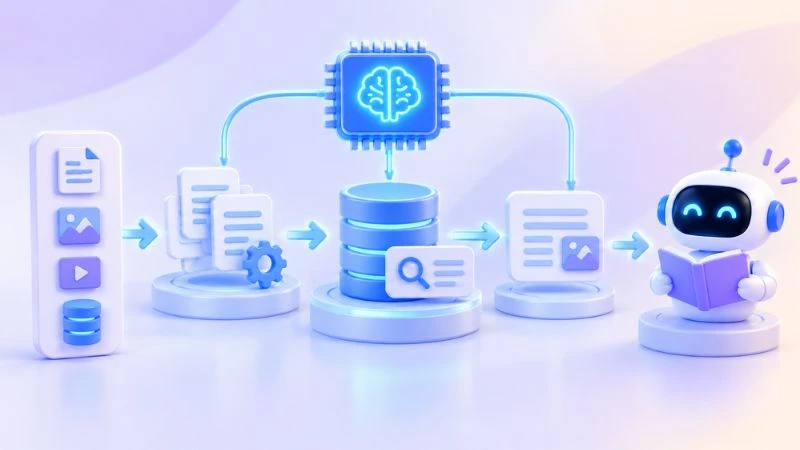
Die wichtigsten Komponenten eines RAG-Systems
| Komponente | Komponente |
| Datenquellen und Dokumentenverarbeitung | Inhalte importieren, extrahieren und aufbereiten |
| Embedding-Modell und Index | Texte für die Suche repräsentieren und indexieren |
| Retriever und optionaler Reranker | Relevante Informationen finden und Suchtreffer bewerten |
| Sprachmodell (LLM) | Antworten auf Grundlage des bereitgestellten Kontexts generieren |
| Prompt-Management und Quellenangaben | Antwortverhalten steuern und verwendete Quellen kenntlich machen |
| Evaluation, Logging und Zugriffskontrolle | Qualität, Systemverhalten und Berechtigungen überwachen |
Klassisches RAG, Advanced RAG und Agentic RAG im Vergleich
- Klassisches RAG: Verbindet eine einfache Suche mit der anschließenden Antwortgenerierung.
- Advanced RAG: Ergänzt beispielsweise hybride Suche, Query Rewriting oder Reranking, um die Retrieval-Qualität zu verbessern.
- Agentic RAG: Nutzt agentenbasierte Abläufe, um mehrere Suchschritte oder Werkzeuge zu koordinieren.
Keine Variante ist grundsätzlich die beste. Die passende Architektur hängt von der Komplexität der Aufgaben, den Qualitätsanforderungen und den verfügbaren Ressourcen ab.
Welche Vorteile bietet RAG für KI-Systeme?
RAG kann generative KI vor allem dann verbessern, wenn Antworten auf externem, aktuellem oder unternehmensspezifischem Wissen beruhen sollen.
- Aktuellere Informationen: Eine gepflegte Wissensbasis lässt sich aktualisieren, ohne das Sprachmodell für jede Änderung neu zu trainieren.
- Weniger Halluzinationen: Relevante Quellen können unbelegte Aussagen reduzieren, verhindern aber nicht alle Fehler.
- Interne Unternehmensdaten: Die KI kann beispielsweise Richtlinien, Handbücher und technische Dokumentationen berücksichtigen.
- Nachvollziehbare Antworten: Quellenverweise erleichtern die Überprüfung der verwendeten Informationen.
- Flexible Wissenspflege: Dokumente können unabhängig vom Sprachmodell aktualisiert und neu indexiert werden.
Wie groß diese Vorteile ausfallen, hängt von der Datenqualität, der Suchstrategie, dem Sprachmodell und der Systemarchitektur ab.
RAG vs. Fine-Tuning vs. klassische KI-Suche – was ist der Unterschied?
RAG, Fine-Tuning und klassische Suche erfüllen unterschiedliche Aufgaben. Die Entscheidung hängt davon ab, ob eine Anwendung externe Informationen benötigt, das Modellverhalten angepasst werden soll oder lediglich passende Inhalte gefunden werden müssen.
| Kriterium | RAG | Fine-Tuning | Klassische KI-Suche |
| Hauptziel | Externes Wissen für Antworten bereitstellen | Modellverhalten oder Aufgabenleistung anpassen | Relevante Inhalte finden |
| Aktuelle Informationen | Durch Aktualisierung der Wissensbasis integrierbar | Änderungen können erneute Anpassungen erfordern | Durch Aktualisierung des Suchbestands verfügbar |
| Generierte Antworten | Ja, durch ein Sprachmodell | Möglich, wenn ein generatives Modell verwendet wird | Nicht zwingend |
| Quellenangaben | Möglich, abhängig von der Implementierung | Nicht automatisch | Suchtreffer können direkt angezeigt werden |
| Typischer Einsatz | Dokumentenbasierte Frage-Antwort-Systeme | Spezifischer Stil, Format oder Aufgaben Verhalten | Dokumentensuche und Informationsrecherche |
Wann ist ein RAG KI nicht notwendig?
Ein vollständiges RAG-System ist nicht immer sinnvoll. Für eine kleine FAQ mit festen Antworten, eine einfache Stichwortsuche oder eine klar definierte Datenbankabfrage kann eine weniger komplexe Lösung ausreichen.
RAG lohnt sich besonders, wenn Informationen aus umfangreichen oder veränderlichen Quellen gesucht und anschließend in natürlicher Sprache zusammengefasst werden sollen. Wenn Sie dagegen zunächst die Kernaussagen eines einzelnen PDF-Dokuments erfassen möchten, kann ein KI-PDF-Zusammenfasser ein passender Ausgangspunkt sein.
Welche Anwendungsfälle gibt es für RAG in Unternehmen?
RAG kann Unternehmen dabei helfen, Informationen aus unterschiedlichen Dokumenten zugänglich zu machen und natürlichsprachliche Fragen auf Grundlage interner Wissensbestände zu beantworten.
Interne Wissensdatenbanken und Unternehmenssuche
Mitarbeiter können Fragen zu Handbüchern, internen Richtlinien und Arbeitsanweisungen stellen. Das System sucht passende Textpassagen und erstellt daraus eine verständliche Antwort. Damit solche Informationen im Unternehmen auffindbar und nutzbar bleiben, spielt auch ein strukturiertes Wissensmanagement eine wichtige Rolle. Mehr dazu erfahren Sie im Beitrag über KI-Wissensmanagement-Software. Voraussetzung sind aktuelle Dokumente und eine zuverlässige Zugriffskontrolle.
Kundenservice und technischer Support
RAG kann Produktbeschreibungen, technische Dokumentationen und freigegebene Supportartikel für die Beantwortung von Kundenfragen nutzen. Bei komplexen oder sicherheitsrelevanten Problemen sollten die Ergebnisse zusätzlich fachlich geprüft werden.
Dokumentenmanagement und Vertragsanalyse
Bei PDF-Dateien, Verträgen und Berichten kann RAG relevante Abschnitte finden und inhaltliche Fragen beantworten. Die Qualität hängt auch von der Textextraktion und der Verarbeitung von Tabellen, Fußnoten und komplexen Dokumentlayouts ab. Rechtlich relevante Aussagen müssen anhand der Originalquelle überprüft werden.
Für die praktische Arbeit mit umfangreichen Dokumenten können ergänzend KI-gestützte Werkzeuge eingesetzt werden. Der KI-Agent für Dokumenten unterstützt beispielsweise dabei, Dokumentinhalte zu extrahieren, wichtige Informationen zusammenzufassen und mehrere Dateien zu analysieren.
Recherche in dynamischen und mehrsprachigen Wissensbeständen
RAG kann Informationen aus mehreren Sprachen und regelmäßig aktualisierten Dokumenten zusammenführen. Mehrsprachige Embeddings und geeignete Suchverfahren können dabei helfen, Fragen und Dokumente in unterschiedlichen Sprachen miteinander zu verbinden. Die Ergebnisse sollten für jede relevante Sprache und Fachterminologie getestet werden.
Wie lassen sich Qualität, Sicherheit und Kosten eines RAG-Systems bewerten?
Ein zuverlässiges RAG-System muss nicht nur passende Informationen finden, sondern auch korrekte Antworten liefern, Daten schützen und wirtschaftlich betrieben werden können. Dafür sollten Unternehmen messbare Qualitätskriterien und regelmäßige Tests einsetzen.
Welche Kennzahlen messen die Qualität eines RAG KI Systems?
| Kennzahl | Bedeutung |
| Retrieval Recall | Wie häufig werden die benötigten relevanten Informationen gefunden? |
| Context Relevance | Wie gut passen die abgerufenen Textabschnitte zur Frage? |
| Faithfulness / Groundedness | In welchem Maß werden die Aussagen durch den bereitgestellten Kontext gestützt? |
| Answer Correctness | Wie korrekt ist die Antwort im Vergleich zu einer geprüften Referenz? |
| Latenz | Wie lange dauert die Verarbeitung einer Anfrage? |
| Kosten pro Anfrage | Welche Kosten entstehen durch Suche, Modellaufrufe und weitere Verarbeitung? |
Diese Kennzahlen sollten gemeinsam betrachtet werden. Gute Suchergebnisse garantieren noch keine korrekte Antwort. Ein repräsentativer Testdatensatz mit geprüften Referenzantworten hilft, Fehler systematisch zu erkennen.
Wie werden Halluzinationen und falsche Quellen erkannt?
- Testdatensätze: Typische, schwierige und mehrdeutige Fragen systematisch prüfen.
- Quellenprüfung: Kontrollieren, ob die angeführten Textstellen die Aussagen tatsächlich belegen.
- Tests ohne Antwortgrundlage: Prüfen, ob das System fehlende Informationen erkennt, statt eine Antwort zu erfinden.
- Menschliche Kontrolle: Kritische oder auffällige Ergebnisse regelmäßig überprüfen.
Automatisierte Bewertungsverfahren können die Kontrolle ergänzen, sollten bei wichtigen Entscheidungen aber nicht die einzige Prüfinstanz sein.
Wie lassen sich Unternehmensdaten und Zugriffsrechte schützen?
- Datenminimierung: Nur erforderliche Informationen verarbeiten.
- Dokumentenbezogene Berechtigungen: Unzulässige Inhalte bereits beim Retrieval ausschließen.
- Protokollschutz: Verhindern, dass vertrauliche Daten unkontrolliert in Logs oder Auswertungen gelangen.
- Datenaufbewahrung: Speicherfristen, Löschung und Übertragung klar regeln.
- Schutz vor Prompt Injection: Manipulierte Dokumentinhalte als potenzielles Sicherheitsrisiko behandeln.
- Vertrags- und Datenschutzprüfung: Datenverarbeitung, Speicherorte und Bedingungen externer Anbieter prüfen.
Ein lokaler Betrieb allein garantiert keine vollständige Sicherheit. Entscheidend ist das Zusammenspiel aus technischer Architektur, Zugriffskontrolle und organisatorischen Maßnahmen.
Welche Kosten und Latenzen entstehen im Betrieb?
Die Kosten eines RAG-Systems entstehen unter anderem durch Dokumentenverarbeitung, Embeddings, Indexpflege, Suchanfragen, optionales Reranking und LLM-Aufrufe. Hinzu kommen Speicher-, Infrastruktur- und Wartungskosten.
Die Latenz hängt von der Suchstrategie, der Anzahl der Verarbeitungsschritte, der Größe des Kontexts und dem verwendeten Sprachmodell ab. Komplexere Abläufe können bessere Ergebnisse liefern, benötigen aber häufig mehr Zeit und Ressourcen.
Unternehmen sollten deshalb Antwortqualität, Laufzeit und Kosten gemeinsam messen, statt nur den Preis einzelner Modellaufrufe zu betrachten.
Welche Grenzen und Herausforderungen hat RAG?
Trotz seiner Vorteile ist RAG kein Garant für korrekte Antworten. Die Qualität hängt von den verwendeten Daten, der Suche, dem Sprachmodell und den Sicherheitsmechanismen ab.
Unvollständige oder veraltete Dokumente
Fehlen wichtige Informationen oder sind Dokumente nicht aktuell, kann das System keine verlässliche Antwort daraus ableiten. Eine geregelte Aktualisierung und Versionierung der Wissensbasis ist deshalb entscheidend.
Schlechte Suchergebnisse und falsch aufgeteilte Textpassagen
Ungeeignetes Chunking, fehlerhafte Textextraktion oder eine unpassende Suchstrategie können relevante Zusammenhänge zerstören. Bei gescannten Dokumenten kann eine unzureichende Texterkennung das Problem zusätzlich verschärfen. Wie OCR mit KI bei der Erkennung von Texten in Dokumenten helfen kann, ist deshalb auch für die Qualität nachgelagerter RAG-Prozesse relevant. Dadurch erhält das Sprachmodell möglicherweise unvollständige oder irrelevante Informationen.
Prompt Injection und manipulierte Dokumentinhalte
Externe Inhalte können schädliche Anweisungen enthalten, die das Modell zu unerwünschtem Verhalten verleiten. Zugriffsbeschränkungen, die Trennung vertrauenswürdiger Anweisungen von abgerufenen Inhalten und gezielte Sicherheitstests sind wichtige Schutzmaßnahmen.
Hoher Wartungsaufwand und steigende Betriebskosten
Ein produktives System benötigt regelmäßige Datenpflege, Indexaktualisierungen, Qualitätskontrollen und Sicherheitsprüfungen. Mit wachsender Datenmenge oder komplexeren Abläufen können zudem Kosten und Antwortzeiten steigen.
Warum RAG keine vollständig fehlerfreien Antworten garantiert
RAG kann passende Quellen bereitstellen, doch das Sprachmodell kann diese falsch interpretieren, wichtige Einschränkungen übersehen oder unbelegte Schlussfolgerungen ziehen. Bei rechtlichen, finanziellen oder sicherheitskritischen Fragen sind deshalb zusätzliche fachliche Prüfungen erforderlich.

 Kostenlos herunterladen
Häufige Fragen zu RAG KI
Fazit
RAG verbindet Informationssuche und Textgenerierung, sodass KI-Systeme externe Wissensquellen für ihre Antworten nutzen können. Besonders Unternehmen profitieren davon, wenn sie umfangreiche Dokumente zugänglich machen und aktuelle Informationen nutzen möchten.
Die Antwortqualität hängt von Datenqualität, Retrieval und Zugriffskontrolle ab. RAG kann Halluzinationen reduzieren, garantiert jedoch keine fehlerfreien Ergebnisse. Für die Arbeit mit digitalen Dokumenten und KI-gestützten Werkzeugen bietet iBoomto weitere Lösungen.
War dieser Beitrag hilfreich?
Vielen Dank für Ihr Feedback!