Anmelden
Anmelden
Kein Schnickschnack. Nur kostenlose Neuigkeiten. (Demos, Credits, Updates und gelegentlich etwas, worauf wir besonders stolz sind)
Vielen Dank für Ihr Abonnement! Freuen Sie sich auf Demos, Credits und Updates.
Ein wichtiges Vertragsdokument liegt als gescanntes PDF vor, dessen Textinformationen jedoch nicht kopiert oder durchsucht werden können. In diesem Fall ist OCR-Technologie erforderlich, um den Text zu erkennen und in durchsuchbare und kopierbare Daten umzuwandeln. Herkömmliche Texterkennungstechnologien stoßen jedoch oft an ihre Grenzen: Beispielsweise lassen sich verschachtelte Tabellen, handschriftliche Anmerkungen oder mehrsprachige Absätze nur schwer präzise erkennen. Künstliche Intelligenz (KI) in der optischen Zeichenerkennung (OCR) kann diese Probleme effektiv lösen. Dieser Blog erklärt, wie KI die OCR verändert, wie sie funktioniert, welche Vorteile sie bietet und welche praktischen Anwendungen es gibt. Wenn Sie mit KI-OCR noch nicht vertraut sind oder Fragen haben, finden Sie in diesem Leitfaden die Antworten.
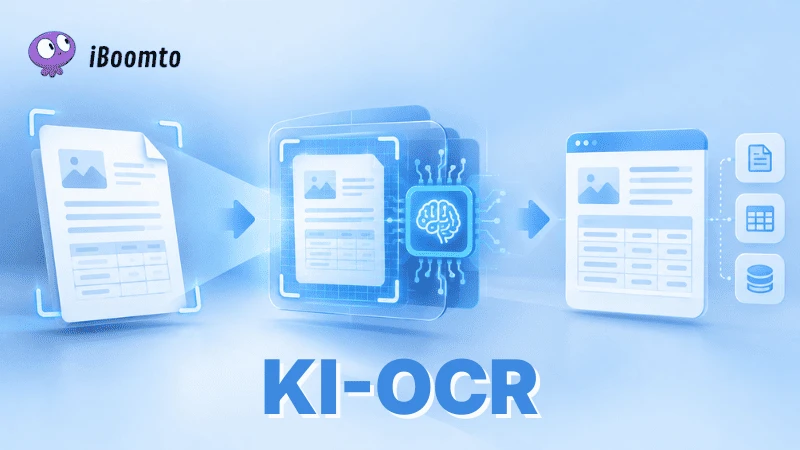
OCR (Optical Character Recognition), zu Deutsch optische Zeichenerkennung, ist ein Verfahren, das gedruckten oder handschriftlichen Text in einem Bild oder gescannten Dokument identifiziert und in maschinenlesbaren, editierbaren Text umwandelt. Klassische OCR-Systeme arbeiten überwiegend musterbasiert: Sie vergleichen die Form einzelner Zeichen mit hinterlegten Schriftmustern und ordnen ihnen entsprechende Buchstaben oder Ziffern zu.
Diese Methode funktioniert zuverlässig bei sauber formatierten, maschinengeschriebenen Texten mit einfachem Layout. Bei komplexeren Dokumenten – etwa mit unregelmäßigen Schriftarten, gescannten Formularen, mehrspaltigem Layout oder handschriftlichen Ergänzungen – stößt klassisches OCR jedoch schnell an technische Grenzen.
Eine häufig gestellte Frage zur OCR-Technologie lautet: Ist OCR im Wesentlichen künstliche Intelligenz? Die Antwort: Nicht unbedingt. Traditionelle OCR basiert primär auf regelbasierten Algorithmen und Mustererkennung, nicht auf lernenden Systemen. Wie also verändert künstliche Intelligenz die traditionelle OCR? Der entscheidende Unterschied liegt in der Verarbeitungslogik: Traditionelle OCR wendet feste Regeln an, während KI-gestützte OCR aus großen Datensätzen lernt, selbstständig Muster erkennt und sich an neue Schriftarten, Sprachen oder Layouts anpassen kann, ohne dass für jede Änderung manuelle Programmierung erforderlich ist. Dadurch ist KI-gestützte OCR effizienter als traditionelle Methoden, insbesondere bei der Verarbeitung komplexer, unstrukturierter oder mehrsprachiger Dokumente. Echte KI-OCR lässt sich daher durch die Kombination von maschinellem Lernen und neuronalen Netzen realisieren.
| Kriterium | Klassisches OCR | KI-OCR (Deep Learning / multimodal) |
| Funktionsprinzip | Regel- und vorlagenbasiert: Binarisierung, Schräglagenkorrektur, Zeichensegmentierung, anschließend Merkmalsabgleich einzelner Zeichen | Auf neuronalen Netzen basiert: CNN und Transformer für Texterkennung und Sequenzerkennung (z. B. DBNet, CRNN, TrOCR); neuere Ansätze nutzen Vision-Language-Modelle (VLM) für ein durchgängiges Dokumentenverständnis |
| Verarbeitungsablauf | Mehrstufige Pipeline: Vorverarbeitung → Layoutanalyse → Zeilen-/Zeichensegmentierung → Zeichenerkennung → Nachbearbeitung; Fehler summieren sich entlang der Kette | Erkennung und Auswertung lassen sich durchgängig (End-to-End) trainieren; VLMs geben strukturierten Text (Markdown/JSON) direkt aus dem Bild aus |
| Handschrifterkennung | Sehr schwach, praktisch nur für normierte Handschrift (z. B. Ziffern) geeignet | Deutlich besser und für viele Handschriftstile nutzbar, bleibt aber hinter gedrucktem Text zurück |
| Layout- und Strukturverständnis | Auf feste Vorlagen oder Regeln angewiesen; Tabellen, mehrspaltige Layouts und gemischte Text-Bild-Seiten nur eingeschränkt möglich | Layoutanalyse, Tabellenrekonstruktion, Erkennung der Lesereihenfolge und Formelerkennung |
| Mehrsprachigkeit | Pro Sprache meist eigene Engine bzw. Zeichensätze; gemischtsprachige Dokumente problematisch | Ein Modell kann mehrere Sprachen gleichzeitig verarbeiten (z. B. Deutsch, Englisch, Chinesisch); besser bei Umlauten, Ligaturen und Sonderzeichen |
| Semantisches Verständnis | Kaum vorhanden; Fehlerkorrektur höchstens über Wörterbücher | Kontextbezogene Korrektur, Extraktion von Schlüsselfeldern (Key Information Extraction) und Erkennung des Dokumenttyps |
| Typische Einsatzgebiete | Standardisierte Druckdokumente, feste Belegformate, Kennzeichenerkennung, etablierte Scan-Archivierung | Rechnungen, Verträge, Ausweise, handschriftliche Formulare, komplexe Berichte, PDF-Parsing, Fototranslation, RAG-Dokumentenanalyse, Wissensdatenbanken |
| Datenschutz | Lokale Verarbeitung, geringes Risiko | Bei Cloud-Lösungen werden Dateien übertragen; lokaler oder privater Betrieb ist möglich |
| Hauptgrenzen | Hohe Anforderungen an Bildqualität und Format; komplexe Layouts schwierig; geringe Flexibilität | Höhere Kosten und Latenz; Halluzinationen möglich; bei untypischen Dokumenten weiterhin Fehler möglich |
Die technische Grundlage von KI OCR besteht aus mehreren aufeinander aufbauenden Verarbeitungsschritten, die gemeinsam eine präzise OCR-Texterkennung ermöglichen.
1. Bilderfassung und Vorverarbeitung
Zunächst wird das Dokument digitalisiert oder als Bilddatei eingelesen. In der Vorverarbeitung werden Störfaktoren wie Schräglage, Rauschen oder ungleichmäßige Belichtung korrigiert, um die Erkennungsgenauigkeit zu verbessern.
2. Layoutanalyse
Im nächsten Schritt analysiert das System die Dokumentstruktur: Textblöcke, Tabellen, Überschriften, Bilder und Spalten werden identifiziert und in ihrer logischen Reihenfolge erfasst. Diese Layoutanalyse ist ein entscheidender Vorteil gegenüber klassischem OCR, das Layoutinformationen häufig nicht berücksichtigt.
3. Zeichenerkennung durch neuronale Netze
Anstelle starrer Musterabgleiche kommen bei KI-OCR neuronale Netze zum Einsatz, die auf Basis umfangreicher Trainingsdaten Zeichen, Wörter und Schriftarten erkennen – auch bei Handschrift, ungewöhnlichen Fonts oder schlechter Bildqualität.
4. Kontextuelle Nachbearbeitung durch NLP
Abschließend wird der erkannte Text durch Verfahren der natürlichen Sprachverarbeitung (Natural Language Processing, NLP) kontextuell überprüft. Dadurch können Erkennungsfehler korrigiert werden, indem das System den semantischen Zusammenhang eines Satzes berücksichtigt – ein Merkmal, das klassisches OCR nicht bietet.
Durch dieses Zusammenspiel aus Bildverarbeitung, neuronalen Netzen und Sprachverständnis erreicht KI OCR eine deutlich höhere Erkennungsgenauigkeit als rein regelbasierte Systeme.
Im direkten Vergleich zur klassischen OCR-Technologie bietet KI OCR mehrere wesentliche Vorteile:
Diese Vorteile machen KI OCR zu einer zentralen Technologie für Unternehmen und Institutionen, die regelmäßig große Mengen unstrukturierter Dokumente verarbeiten müssen.
Die auf künstlicher Intelligenz basierende Technologie zur optischen Zeichenerkennung wird primär in intelligenten Dokumentenverarbeitung (IDP) eingesetzt. Ihre potenziellen Anwendungsbereiche sind sehr breit gefächert und umfassen zahlreiche Branchen, die die digitale Erfassung, Suche oder Weiterverarbeitung großer Dokumentenmengen erfordern.
Kanzleien und Rechtsabteilungen verarbeiten regelmäßig umfangreiche Aktenbestände, Verträge und gerichtliche Schriftstücke. KI OCR ermöglicht die zuverlässige Digitalisierung dieser Dokumente, selbst wenn sie handschriftliche Vermerke, Stempel oder komplexe Formatierungen enthalten, und erleichtert dadurch die gezielte Suche nach relevanten Textpassagen.
Im Finanzbereich fallen kontinuierlich strukturierte und teilstrukturierte Dokumente wie Rechnungen, Quittungen oder Kontoauszüge an. KI-gestützte Texterkennung extrahiert relevante Datenfelder – etwa Beträge, Rechnungsnummern oder Fälligkeitsdaten – automatisiert und reduziert damit den manuellen Erfassungsaufwand erheblich.
Bildungseinrichtungen und Forschungsinstitute nutzen KI OCR, um gescannte Lehrmaterialien, historische Dokumente oder wissenschaftliche Publikationen in durchsuchbare und weiterverarbeitbare Formate zu überführen. Insbesondere bei mehrsprachiger Fachliteratur zeigt sich der Vorteil kontextsensitiver Texterkennung.
Behörden verarbeiten tagtäglich Anträge, Formulare und amtliche Schreiben. KI OCR unterstützt die Digitalisierung dieser Vorgänge und trägt zur Beschleunigung interner Prozesse bei.
Unabhängig von der Branche profitieren Unternehmen von einer durchsuchbaren, strukturierten Dokumentenablage. KI OCR bildet hierfür häufig die technische Grundlage, insbesondere in Kombination mit Systemen der intelligenten Dokumentenverarbeitung.
Für Nutzer, die KI-Texterkennung ausprobieren möchten, stehen zahlreiche kostenlose Tools zur Verfügung. Viele kostenlose OCR-KI-Lösungen bieten jedoch nur eingeschränkte Funktionen. Sie können beispielsweise nur eine begrenzte Anzahl von Seiten oder Dokumenten verarbeiten, unterstützen weniger Sprachen und haben Schwierigkeiten mit komplexen Layouts wie Tabellen oder mehrspaltigem Text. In manchen Branchen ist der Datenschutz bei der Verarbeitung sensibler Dokumente, die besondere Aufmerksamkeit erfordern, von höchster Bedeutung. In solchen Fällen empfiehlt sich die Verwendung sicherer und zuverlässiger, lokal installierter Software.
Daher empfehlen wir die Windows-Software von iBoomto, die eine kostenlose Testversion umfassender KI-OCR-Technologie bietet.
iBoomto AI ist eine intelligente Dokumentenverarbeitung Software speziell für Windows. Sie bietet einen kostenlosen Basistarif, mit dem Sie jedes Dokument problemlos verarbeiten können. Bearbeitung, Formatkonvertierung, Inhaltsanalyse und Extraktion sind kostenlos. Nutzer können PDF-Dokumente hochladen und mithilfe von KI-Texterkennung Technologie analysieren lassen, einschließlich gescannter Dokumente sowie Dokumente mit Bildern und Tabellen. Die gesamte Verarbeitung erfolgt auf Ihrem Computer, und die Daten sind sicher geschützt. So bestehen keine Bedenken hinsichtlich Datenlecks beim Hochladen in die Cloud.

 Kostenlos herunterladen
Die folgenden Beispiele veranschaulichen, wie die KI-OCR-Technologie von iBoomto AI in unterschiedlichen beruflichen Kontexten zur Anwendung kommen kann.
Wenn Sie als Jurist ein gescanntes Rechtsdokument bearbeiten müssen, das schwer lesbar ist und in dem Sie die benötigten Informationen nicht schnell finden, kann Ihnen ein Tool mit KI-gestützter OCR-Technologie helfen, Ihr Ziel schnell zu erreichen.
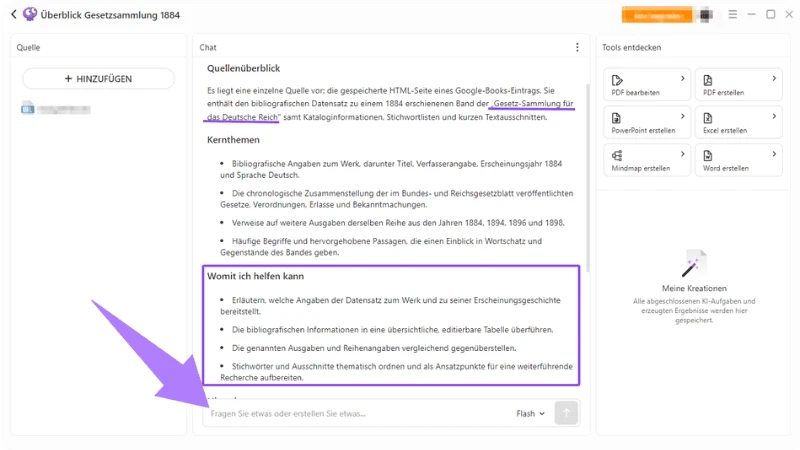
Laden Sie die PDF-Datei oder den Link zu iBoomto AI hoch. Die KI-gestützte OCR-Technologie erkennt den Inhalt im Handumdrehen. Sie können dem Chatbot auch direkt Fragen zu Rechtsdokumenten stellen, um die benötigten Informationen effizient zu finden.
Datei Beispiel: Gesetz-Sammlung Für Das Deutsche Reich; Chronologische Zusammenstellung Der in Dem Bundes- und Reichs- Gesetzblatte Veröffentlichten Gesetze, Verordnungen, Erlasse und Bekanntmachungen
Laden Sie eine Datei direkt hoch oder gib einen Link ein.
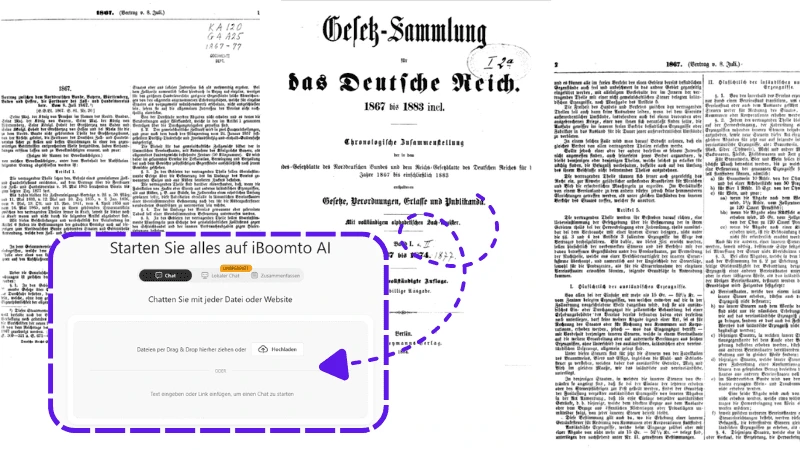
Eingescannte PDF-Datei; der Dokumentinhalt ist schwer lesbar und schnell verständlich. Die KI-OCR-Technologie macht das Lesen von Dokumenten genauer und effizienter.
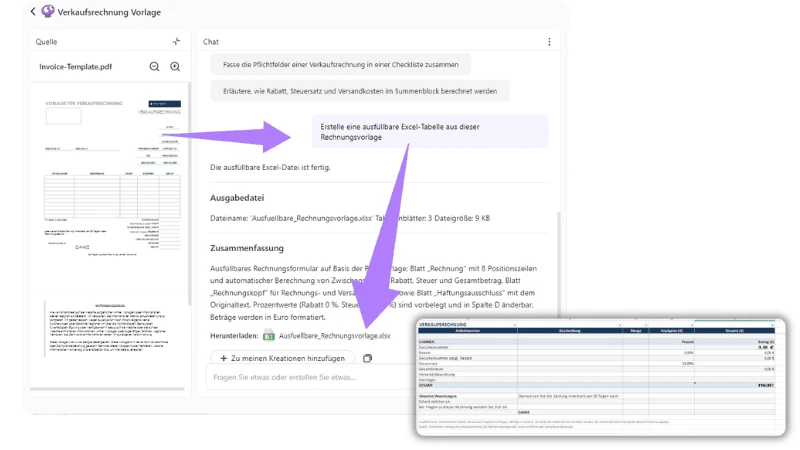
Finanz- und Buchhaltungsabteilungen erhalten monatlich eine Vielzahl von Rechnungen in unterschiedlichen Formaten – teils als Scans, teils in Tabellenkalkulationen eingebettet. Durch das direkte Hochladen mehrerer Dateien in iBoomto AI kann die KI-OCR-Technologie tabellarische Daten wie Rechnungsbeträge und Zahlungsbedingungen direkt aus allen Dokumenten extrahieren und so die manuelle Dateneingabe erheblich reduzieren.
Datei Beispiel: Rechnung (PDF Datei)
Laden Sie eine Datei direkt hoch oder gib einen Link ein.
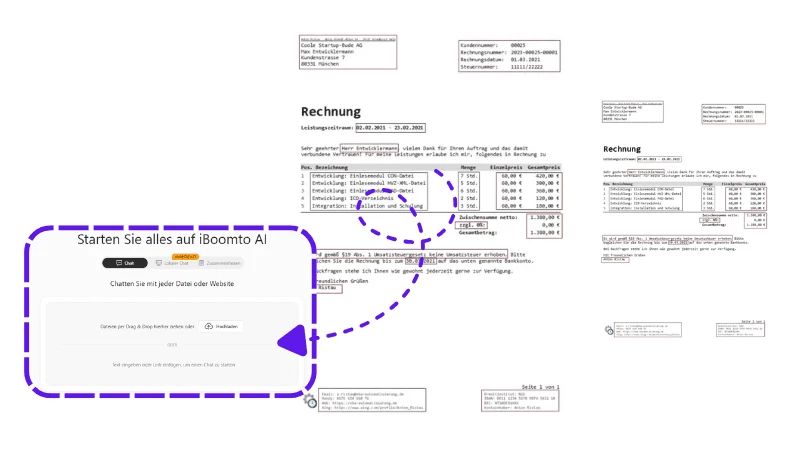
Tabellen identifizieren, Daten extrahieren und in das Excel-Format umwandeln
In den Bereichen Literaturwissenschaft und Pädagogik wird wissenschaftliche Literatur in verschiedenen Sprachen genutzt, darunter auch englisch- und französischsprachige Publikationen. Die mehrsprachige Texterkennungstechnologie von iBoomto AI erfasst den Inhalt dieser Dokumente unabhängig von der Ausgangssprache und stellt mithilfe eines Chatbots gezielte, zum Inhalt der Publikation relevante Fragen. Bei Bedarf lassen sich die extrahierten Fragen auch in PowerPoint-Präsentationen umwandeln.
Datei Beispiel: The Autobiography of Goethe
Laden Sie eine Datei direkt hoch oder gib einen Link ein.
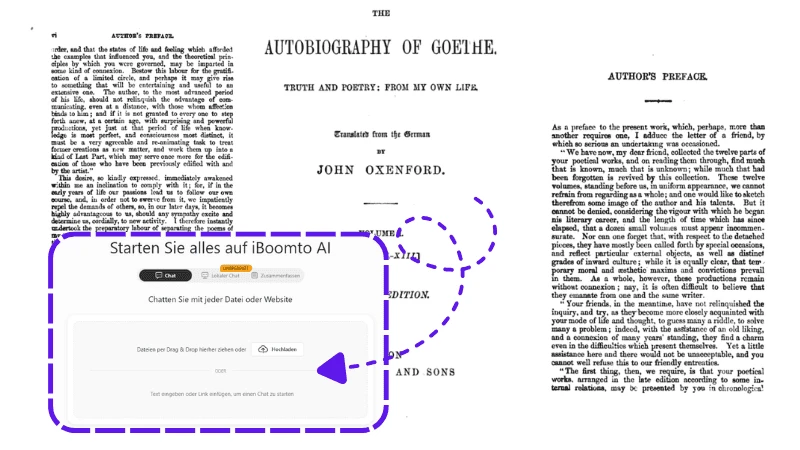
Die KI-gestützte OCR interpretiert gescannte PDF-Dokumente effizient, findet schnell wichtige Informationen und wandelt sie in nutzbare Dateien um.
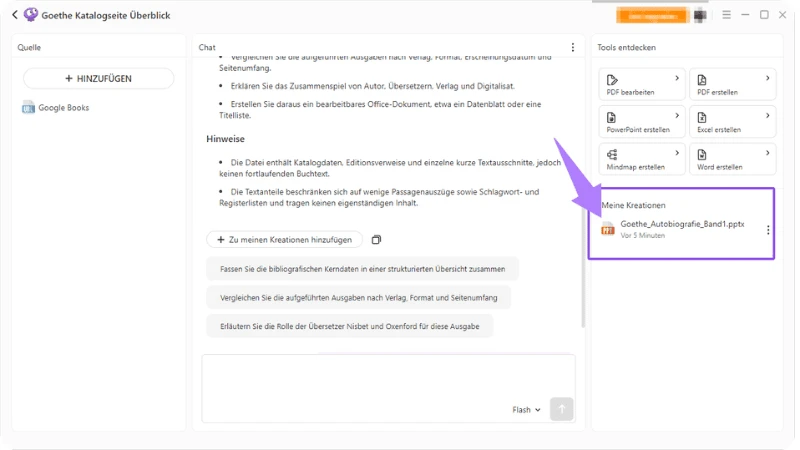
KI OCR bietet weitaus mehr Anwendungsmöglichkeiten als die oben genannten. Dies sind nur drei einfache Beispiele; viele weitere kreative Einsatzmöglichkeiten warten darauf, von Ihnen entdeckt zu werden.
Obwohl KI-gestützte OCR-Technologie Dokumente in nutzbare Daten umwandeln kann, müssen bestimmte Risiken und Herausforderungen berücksichtigt werden, insbesondere im Hinblick auf Datenschutz und Datensicherheit.
Viele Dokumente, die mittels KI OCR digitalisiert werden, enthalten personenbezogene oder vertrauliche Informationen – etwa Verträge, Patientendaten, Finanzunterlagen oder interne Geschäftsdokumente. Werden solche Dokumente über cloud-basierte Systeme verarbeitet, stellt sich grundsätzlich die Frage, wo und wie diese Daten gespeichert, übertragen und verarbeitet werden.
Insbesondere Unternehmen und Institutionen, die strengen regulatorischen Vorgaben unterliegen – etwa im Rechts-, Finanz- oder Gesundheitswesen – müssen sicherstellen, dass die eingesetzte KI-OCR-Lösung geltenden Datenschutzbestimmungen entspricht. Dies betrifft sowohl die Speicherung der Dokumente als auch die Frage, ob und in welchem Umfang Daten an Drittanbieter oder externe Server übermittelt werden.
Cloud-basierte OCR-Lösungen bieten in der Regel eine hohe Flexibilität und einfache Zugänglichkeit, bergen jedoch bei besonders sensiblen Dokumenten potenzielle Risiken hinsichtlich der Datenkontrolle. Eine lokale Verarbeitung, bei der Dokumente das eigene System nicht verlassen, kann in solchen Fällen eine sinnvolle Alternative darstellen, da sie die Kontrolle über die Daten vollständig beim Anwender belässt.
Vor diesem Hintergrund bietet iBoomto mit seiner dualen Verarbeitungsarchitektur aus Cloud- und lokaler Verarbeitung einen Ansatz, der es Nutzerinnen und Nutzern ermöglicht, je nach Sensibilität der Dokumente selbst zu entscheiden, welcher Verarbeitungsmodus im Einzelfall angemessen ist.
Durch den Einsatz neuronaler Netze und Technologien zur Verarbeitung natürlicher Sprache erkennt KI OCR nicht nur einzelne Zeichen, sondern versteht auch Dokumentlayout, Kontext und semantische Zusammenhänge. In Kombination mit intelligenter Dokumentenverarbeitung optimiert sie PDF-Workflows.
Für alle, die KI-OCR-Technologie mit Datenschutz Aspekten verbinden möchten, bietet iBoomto AI die optimale Lösung: Ob es um das Scannen von Verträgen im Rechtsbereich, das Zusammenstellen umfangreicher Rechnungslisten im Finanzwesen oder die Bearbeitung mehrsprachiger Fachdokumente in Bildung und Wissenschaft geht – iBoomto AI analysiert Dokumente intelligent, sowohl in der Cloud als auch lokal, basierend auf Datenschutzbestimmungen und dem Umfang der Verarbeitung. Sind Sie neu in der Welt der KI-OCR? Dann starten Sie mit iBoomto. Auch wenn Sie bereits Erfahrung mit KI-OCR haben, ist iBoomto AI einen Versuch wert – testen Sie es jetzt und vergleichen Sie selbst!