Anmelden
Anmelden
Kein Schnickschnack. Nur kostenlose Neuigkeiten. (Demos, Credits, Updates und gelegentlich etwas, worauf wir besonders stolz sind)
Vielen Dank für Ihr Abonnement! Freuen Sie sich auf Demos, Credits und Updates.
Forschungsmaterialien, Patientenakten, Dienstpläne, Produkthandbücher, Verträge, Angebote und andere Dokumente werden üblicherweise im PDF-Format gespeichert. Diese Dokumente enthalten eine Fülle wichtiger Informationen, und das bloße Lesen reicht für die tägliche Recherche oder Arbeit oft nicht aus. Daher ist es mitunter notwendig, den Inhalt von PDFs für weitere Analysen oder zur Organisation auszulesen. PDFs sind jedoch im Wesentlichen ein „Druckformat“, und die Datenextraktion ist im Vergleich zu anderen Dokumentformaten nicht so einfach. Wie lässt sich also PDF einfach auslesen? Derzeit ist der Einsatz von KI-Tools die beste Lösung.
Wie man künstliche Intelligenz zum Lesen von PDF-Dateien verwendet? Welche technischen Prinzipien liegen dem zugrunde? Welche Teile eines PDFs können gelesen werden? Welche Tools eignen sich? Lesen Sie diesen Artikel für eine umfassende Anleitung.
Beim Auslesen einer PDF-Datei mit künstlicher Intelligenz wird der Inhalt nicht nur als Text erfasst, sondern in Struktur und Bedeutung verstanden. Dafür arbeiten mehrere Technologien in aufeinanderfolgenden Schritten zusammen:
Zunächst wird geprüft, wie die PDF-Datei aufgebaut ist. Digital erzeugte PDF-Dateien enthalten in der Regel eine maschinenlesbare Textebene, aus der sich der Text direkt auslesen lässt. Bei eingescannten Dokumenten liegt dagegen nur ein Bild jeder Seite vor.
Für bildbasierte Seiten kommt die optische Zeichenerkennung (Optical Character Recognition, OCR) zum Einsatz. KI-gestützte Verfahren berücksichtigen dabei auch den Kontext der umgebenden Zeichen und Wörter. Dadurch steigt die Erkennungsgenauigkeit gegenüber klassischer OCR, insbesondere bei unsauberen Scans oder schwierigen Schriftbildern.
Anschließend analysiert die KI den visuellen Aufbau jeder Seite: Wo stehen Überschriften, Absätze, Tabellen, Abbildungen oder Fußnoten, und in welcher Reihenfolge sind sie zu lesen? Diese Analyse ist die Voraussetzung dafür, dass auch mehrspaltige Seiten oder verschachtelte Tabellen korrekt interpretiert werden und Inhalte nicht durcheinandergeraten.
Der Kern der KI-gestützten Auswertung liegt in der Verarbeitung natürlicher Sprache (Natural Language Processing). Sprachmodelle erfassen die Bedeutung von Aussagen und nicht nur einzelne Zeichenketten. Dadurch lassen sich Informationen auch dann zuordnen, wenn sie unterschiedlich formuliert sind, etwa eine Vertragsklausel, die in zwei Dokumenten verschiedene Worte verwendet, inhaltlich aber dasselbe regelt.
Bei längeren Dokumenten wird der Inhalt in sinnvolle Abschnitte gegliedert und so aufbereitet, dass bei einer Frage gezielt die relevanten Stellen gefunden werden. Die Antwort stützt sich dadurch auf konkrete Textpassagen des Dokuments und nicht allein auf das allgemeine Wissen des Sprachmodells. Dieses Vorgehen trägt dazu bei, frei erfundene Aussagen (sogenannte Halluzinationen) zu verringern.
Zuletzt werden die Ergebnisse je nach Anwendungsfall bereitgestellt, etwa als direkte Antwort im Dialog, als Zusammenfassung oder als strukturierter Datensatz, zum Beispiel in Excel, CSV oder JSON.
Es gibt viele kostenlose Tools oder solche mit grundlegenden Funktionen, mit denen sich PDF-Dateien lesen und Daten extrahieren lassen. Im Folgenden finden Sie fünf getestete und praktische Lösungen. Einige extrahieren Daten aus PDFs, andere lesen neben den PDF-Daten auch Metadaten. Wählen Sie das Tool, das Ihren Bedürfnissen entspricht.
iBoomto konzentriert sich auf die Bereitstellung von Werkzeugen zur Bearbeitung von PDFs und anderen Dateitypen, darunter verschiedene Online-PDF-Bearbeitungstools und den KI Agent von iBoomto für Windows. Diese Tools decken vielfältige Anforderungen an die PDF-Bearbeitung ab, beispielsweise das automatische Auslesen von Daten und Metadaten aus PDFs, das Extrahieren von Bildern oder Tabellen. Die Nutzung der iBoomto-Tools ist grundsätzlich kostenlos, es wird jedoch täglich eine begrenzte Anzahl kostenloser Testversionen angeboten. Dies sollte für die meisten Nutzer ausreichend sein. Für die Bearbeitung größerer Dateimengen, die über das Limit der kostenlosen Testversion hinausgehen, ist ein kostenpflichtiges Abonnement erforderlich. Wenn Sie ein kostenloses Tool für die intelligente Dokumentenverarbeitung suchen, kann iBoomto die meisten Ihrer Anforderungen erfüllen.
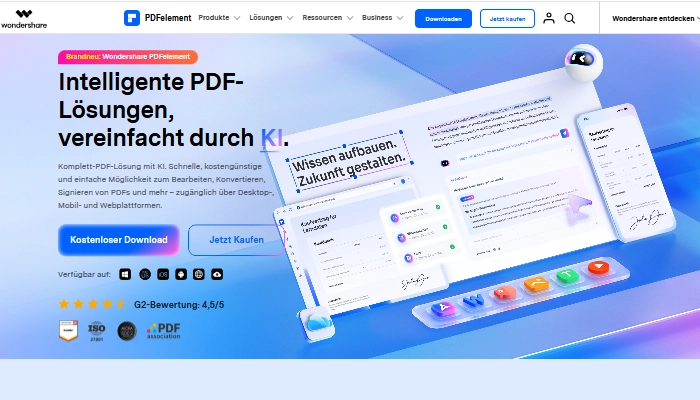
PDFelement ist ein PDF-Editor mit integrierten KI-Modellen, der plattformübergreifend unter Windows, Mac, iOS, Android und im Web genutzt werden kann. Das Tool erkennt Text, Tabellen und Bilder und kann auch gescannte PDF-Dateien verarbeiten und Daten automatisch auslesen. Die Basisversion kann für begrenzte Zeit kostenlos getestet werden. Mitglieder können monatlich eine bestimmte Anzahl von KI-Funktionen kostenlos nutzen. Für die uneingeschränkte Nutzung aller KI-Funktionen ist der Kauf eines kostenpflichtigen Zusatzpakets erforderlich.
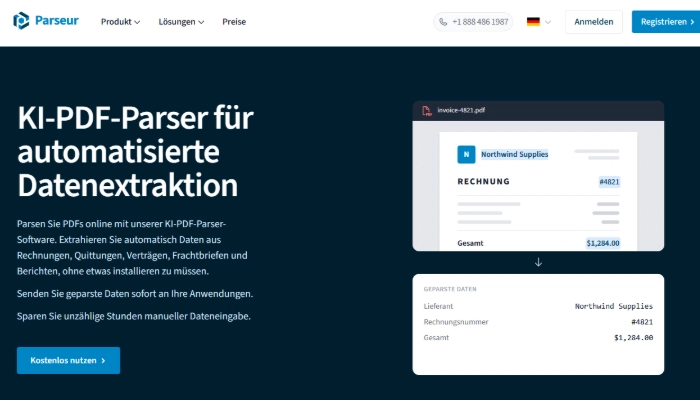
Parseurs KI-PDF-Parser extrahiert automatisch strukturierte Daten aus Dokumenten. Nutzer geben einfach an, welche Datenpunkte aus der PDF-Datei extrahiert werden sollen, und die KI identifiziert und extrahiert diese automatisch. Das Tool unterstützt die Verarbeitung digitalisierter und gescannter PDF-Dateien mithilfe von OCR-Technologie. Die kostenlose Version umfasst die grundlegendsten Funktionen, hat jedoch ein monatliches Verarbeitungslimit.
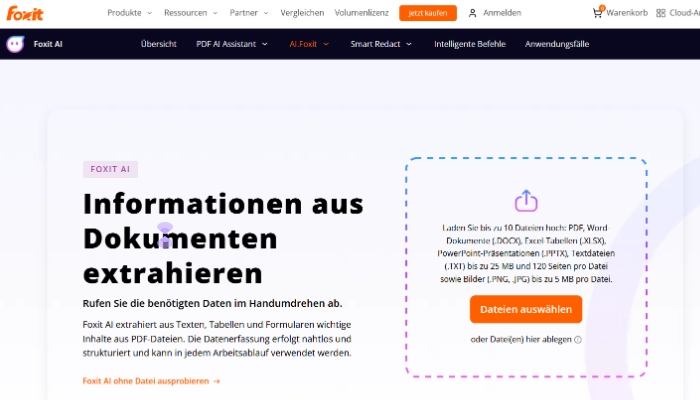
Foxit AI ist die eigenständige KI-Lösung des Anbieters Foxit und ermöglicht die Analyse von PDF-Dateien sowie weiteren Formaten wie Word, Excel oder PowerPoint. Es lassen sich bis zu zehn Dateien gleichzeitig hochladen und auswerten, inklusive OCR-Erkennung für gescannte oder bildbasierte Dokumente. Zudem können gezielte Fragen zu einzelnen Tabellen, Abschnitten oder Feldern innerhalb der Dokumente gestellt werden. Die kostenlose Nutzung umfasst ein begrenztes monatliches Kontingent an Anfragen.
Doxis ist eine auf automatisierte Datenextraktion und intelligente Dokumentenverarbeitung spezialisierte Plattform mit Fokus auf europäische Unternehmen. Mittels OCR und maschinellem Lernen werden Daten aus PDF-Dokumente extrahiert, die Datenhaltung erfolgt innerhalb der EU. Doxis richtet sich in erster Linie an Geschäftskunden; die Kosten richten sich nach Umfang und Anzahl der zu erfassenden Datenfelder, eine kostenlose Version für Privatnutzer wird nicht angeboten.
Die Erkennungsgenauigkeit kann bei schräg gestellten Fotos oder Scans geringer Qualität abnehmen.
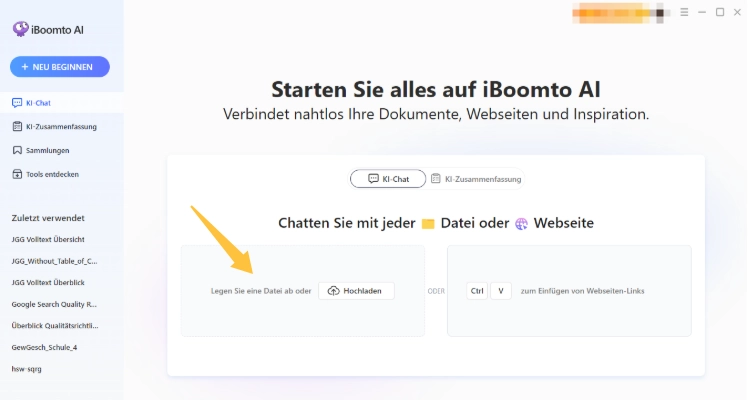
Schritt 1: iBoomto KI Agent herunterladen
Schritt 2: PDF-Datei hochladen und Leseanforderungen beschreiben
Schritt 3: Ergebnisse ansehen und herunterladen oder kopieren
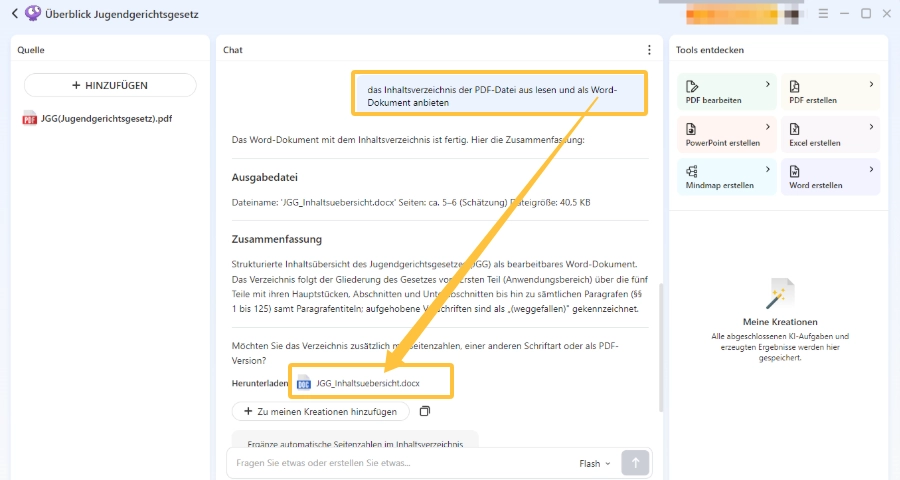
Mit iBoomto ist das Extrahieren von Daten aus PDF-Dateien kinderleicht. Folgen Sie einfach den drei oben genannten Schritten, um auch umfangreiche PDF-Dateien schnell zu durchlesen.

 Kostenlos herunterladen
Künstliche Intelligenz (KI) kann weit mehr als nur reinen Text aus PDF-Dateien extrahieren. Welche Daten extrahiert werden können, hängt vom jeweiligen Dokument und den verwendeten Tools ab. Hier einige der gängigsten Kategorien:
Grundlage ist der sichtbare Text im Dokument, wie Absätze, Überschriften oder Stichpunkte. KI erkennt nicht nur einzelne Wörter, sondern auch Kontextbeziehungen und kann so Absätze zusammenfassen oder gezielt Informationen abrufen.
Tabellen und ihre Zeilen- und Spaltenstrukturen lassen sich ebenfalls extrahieren. Dies ist besonders nützlich für Preislisten, Finanzübersichten oder Analysen, da die Inhalte anschließend in Formate wie Excel oder CSV konvertiert werden können.
KI kann Informationen aus Bildern oder Tabellen extrahieren und in Textform beschreiben; oder sie kann vollständige Bilder und Tabellen separat extrahieren und sie so präsentieren, wie Sie es wünschen.
Für gescannte PDF-Dateien ohne maschinenlesbaren Text wird die optische Zeichenerkennung (OCR) eingesetzt. Je nach Scanqualität können auch Dokumente analysiert werden, die zuvor nur als Bilder vorlagen.
Neben inhaltsbezogenen Informationen lassen sich aus PDF-Dateien auch andere Daten extrahieren. Diese Daten beziehen sich nicht auf den eigentlichen Dokumentinhalt, sondern beschreiben die Datei selbst.
Metadaten sind Informationen über die Datei selbst, nicht über ihren Inhalt, wie beispielsweise der Autor, das Erstellungsdatum, das Programm, mit dem die PDF-Datei erstellt wurde, oder die Dateigröße. Anders als bei der inhaltlichen Textauswertung greift die KI hierbei nicht auf OCR oder semantisches Sprachverständnis zurück, sondern liest die Metadaten direkt aus der internen Dateistruktur des PDF-Formats aus, in der diese Angaben in standardisierten Feldern hinterlegt sind.
Moderne KI-Lösungen können Texte in mehreren Sprachen erkennen und Dokumente in anderen Sprachen analysieren, ohne dass zusätzliche Tools erforderlich sind.
Das Auslesen aus PDF hat sich von der manuellen Ansicht zu automatisierten, KI-gestützten Prozessen entwickelt, die Text, Tabellen und sogar gescannte Dokumente zuverlässig in strukturierte Daten umwandeln. Ob Text, Daten oder Metadaten aus einem PDF ausgelesen werden – KI kann kostenlos und effizient eingesetzt werden.
Die Datenextraktion ist jedoch oft nicht der letzte Schritt. Wie bereits erwähnt, müssen die extrahierten Daten in der Regel weiterverarbeitet werden, beispielsweise analysiert oder verglichen. iBoomto unterstützt diesen gesamten Workflow – vom automatischen Import einzelner PDF-Dateien bis zur dialogbasierten Analyse ganzer Dokumentenbibliotheken – und ermöglicht es Nutzern, nicht nur spezifische Datenpunkte zu extrahieren, sondern auch den gesamten Dokumentenverarbeitungsprozess effizient zu verwalten.