Accedi
Accedi
Niente fronzoli. Solo novità gratuite. (Demo, crediti, aggiornamenti e qualche novità di cui siamo orgogliosi)
Grazie per esserti iscritto! Resta aggiornato su demo, crediti e novità.
Negli ultimi anni sentiamo parlare di chatbot, modelli generativi e assistenti automatici quasi ogni settimana. Il punto è un altro: molti di questi sistemi sanno scrivere bene, ma non sempre sanno se quello che dicono è vero. Ecco perché oggi si parla così spesso di RAG AI. In italiano si traduce come “generazione aumentata dal recupero”: l’idea di base è molto concreta. Prima di rispondere, l’intelligenza artificiale va a cercare documenti reali, li legge e solo dopo prova a scrivere la risposta.
Se hai letto articoli concorrenti su Wired, su blog di agenzie SEO o su siti tecnici italiani, avrai notato che il concetto torna sempre: il modello linguistico da solo è bravo a comporre frasi, ma senza fonti rischia di confondere, aggiornare male i dati o dire cose plausibili ma false. Il RAG AI non sostituisce il modello: gli dà gli appunti giusti prima dell’esame.
In questa guida vediamo insieme RAG AI cosa è, come funziona davvero, dove si usa, dove fallisce e perché chi fa contenuti o prodotti AI non può più ignorarlo.
Quando cerchi cos'è un RAG o RAG significato, il rischio è di incappare in definizioni troppo accademiche. Proviamola in modo umano.
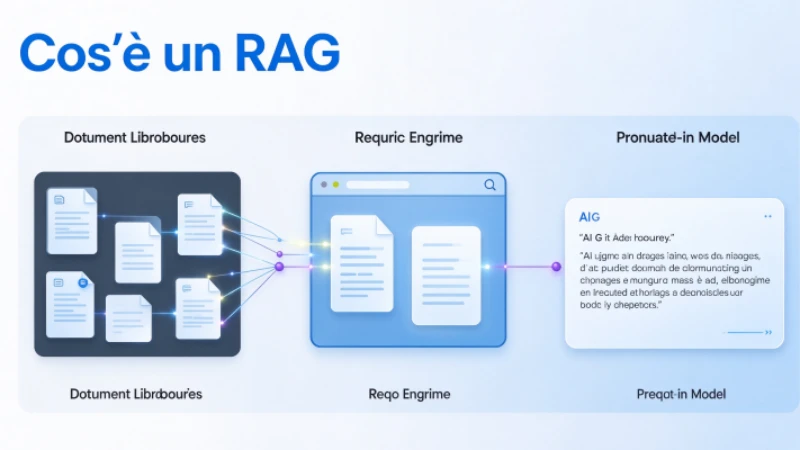
Un sistema RAG è fatto da due pezzi che lavorano in sequenza:
Il termine inglese è Retrieval-Augmented Generation. RAG AI significato: generazione che non parte a memoria, ma viene “aumentata” da documenti recuperati al momento.
Un paragone che funziona sempre: il modello linguistico classico fa l’esame a libro chiuso. Sa tanto, ma se la domanda riguarda una norma uscita ieri o un documento interno della tua azienda, brancola nel buio. Il RAG/LLM invece fa l’esame a libro aperto: prima sfoglia le fonti, poi risponde.
Molti articoli tecnici descrivono il RAG come una pipeline complicatissima. In realtà, se togliamo il gergo, il flusso è chiaro.
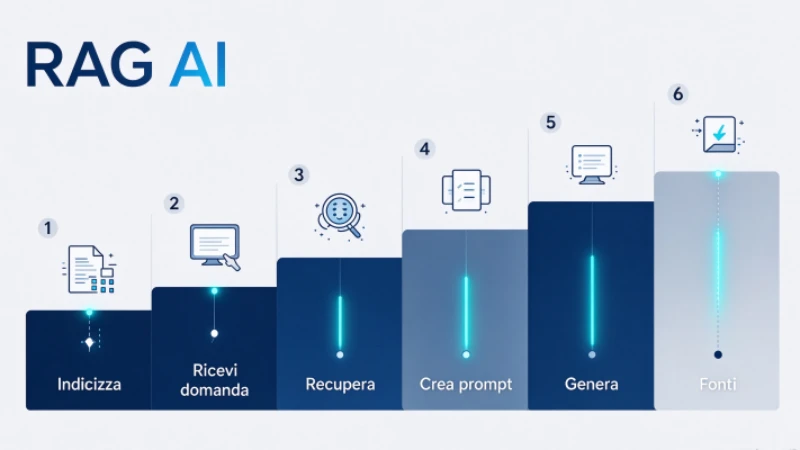
Prima ancora che un utente faccia una domanda, il sistema prepara la "libreria".
I documenti vengono divisi in blocchi più piccoli, detti chunk. Ogni blocco viene trasformato in una rappresentazione numerica, chiamata embedding. Questi vettori finiscono in un database vettoriale, ottimizzato per confrontare significati e non solo parole identiche. Se i documenti di partenza sono PDF, conviene prima convertirli da PDF a Markdown: un testo pulito e strutturato rende i chunk molto più coerenti.
L’utente scrive: “Qual è la procedura di rimborso spese aggiornata?”.
La frase non viene trattata come una semplice parola chiave, ma convertita anch’essa in vettore.
Il sistema cerca i blocchi più simili per senso. Non cerca solo “rimborso spese”, ma anche “nota spese”, “rimborso trasferta”, “policy aziendale viaggi” se il significato è vicino. È qui che il RAG LLM mostra il suo valore: il recupero è semantico, non letterale.
I pezzi recuperati vengono messi insieme alla domanda originale. Il modello riceve un prompt del tipo:
“Rispondi usando solo queste fonti. Fonti: … Domanda: …”.
Il modello scrive la risposta in linguaggio naturale, ma stavolta ha il contesto giusto. Se le fonti dicono una cosa e il modello “da solo” ne direbbe un’altra, il sistema ben fatto deve dare priorità alle fonti recuperate.
Nei casi migliori, la risposta indica da dove arriva l’informazione. Questo è il vero salto di qualità: l’utente può controllare, l’azienda può fidarsi, e il contenuto diventa molto più difendibile.
Ormai quasi tutti hanno capito che un RAG/LLM è più forte di un LLM da solo. Ma perché, nella pratica?
I grandi modelli linguistici hanno un difetto noto: se non sanno una cosa, a volte la inventano con tono sicuro. Si chiama allucinazione. Il RAG AI non elimina il problema al 100%, ma lo riduce molto perché obbliga il modello a partire da documenti veri.
Allenare un modello da zero costa caro e porta via settimane. Con il RAG basta aggiornare la base documentale. Esce una nuova circolare? La carichi. Cambia il listino prezzi? Lo sostituisci nel documento. Il modello resta quello, ma le risposte cambiano.
Un LLM pubblico non sa cosa fa la tua azienda, quali contratti usi, quali manuali interni hai scritto. Il RAG intelligenza artificiale permette di collegare l’AI ai documenti privati, mantenendo il linguaggio naturale del modello e la concretezza dei dati reali.
Chi usa l’AI in sanità, legale, pubblica amministrazione o supporto clienti non vuole frasi belle: vuole sapere perché il sistema ha risposto così. Il RAG aiuta perché la risposta può essere tracciata fino ai documenti recuperati.
Spesso i clienti chiedono: “Ma io ho già ChatGPT, perché mi serve il RAG?”. La tabella qui sotto aiuta a chiarire i termini senza fronzoli.
| Aspetto | LLM classico | RAG AI |
| Fonte delle informazioni | Conoscenza appresa in fase di addestramento | Documenti recuperati al momento + modello |
| Aggiornamento | Serve riaddestramento o fine-tuning | Basta aggiornare i documenti |
| Dati aziendali privati | Spesso non disponibili o generici | Recuperabili da base interna |
| Rischio di allucinazione | Più alto su fatti recenti o specifici | Più basso se la ricerca funziona bene |
| Citabilità delle fonti | Debole | Centrale nei sistemi ben progettati |
| Costi di manutenzione | Alti se vuoi conoscenza nuova nel modello | Più gestibili: si aggiorna la knowledge base |
In sintesi: l’LLM è il “cervello che scrive”, il RAG AI è il metodo che gli mette davanti i documenti giusti prima di scrivere.
Non parliamo di laboratorio. Il RAG AI è già ovunque, anche quando non lo vedi.
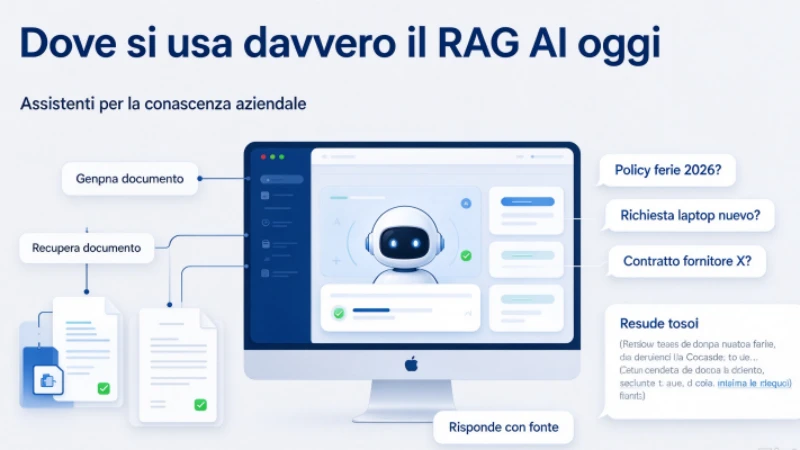
"Dov'è la policy ferie 2026?", "Come richiedo un laptop nuovo?", "Cosa dice il contratto con il fornitore X?". Invece di perdere tempo tra intranet e PDF, l'assistente AI recupera il documento e risponde con fonte alla mano.
I chatbot vecchia scuola rispondevano con frasi fisse. Quelli basati su AI RAG leggono FAQ, manuali prodotto, storico ticket e danno risposte molto più vicine al caso reale.
In Italia si sta parlando molto di RAG per la pubblica amministrazione: manuali operativi, bandi, regolamenti. Invece di sfogliare centinaia di pagine, l’operatore fa una domanda e il sistema estrae i passi pertinenti.
Google AI Overviews, ChatGPT con ricerca, Perplexity e altri sistemi funzionano proprio così: recuperano pagine, le leggono, generano la risposta e citano le fonti. Chi fa contenuti oggi non compete solo per la posizione 1: compete per essere il pezzo che il sistema recupera e cita.
Qui non puoi permetterti che l’AI dica “secondo me”. Serve la norma, la circolare, il foglio informativo. Il RAG LLM diventa lo strato che tiene l’AI dentro il recinto dei documenti autorizzati.
Un articolo onesto non può fermarsi ai vantaggi. Il RAG AI ha diverse insidie, e chi le ignora costruisce demo bellissime che poi falliscono in produzione.
Il modello può essere potentissimo, ma se il retriever tira fuori documenti poco pertinenti, la risposta sarà convincente e sbagliata. Garbage in, garbage out, versione AI.
PDF scannerizzati male, intestazioni confuse, linguaggio ambiguo: tutto questo riduce la qualità del recupero. Il RAG intelligenza artificiale funziona bene solo se la base documentale è curata. Un passaggio delicato è estrarre tabelle da PDF: se le tabelle si rompono, il sistema perde dati preziosi.
A volte si recuperano troppi pezzi. Il modello si ritrova un prompt enorme, perde il filo e mescola informazioni diverse. Serve una buona strategia di chunking, ranking e sintesi.
Se colleghi il RAG all’archivio aziendale, devi gestire bene i diritti. Un utente non deve recuperare documenti riservati di un altro reparto. Qui il rischio non è solo l’errore: è la fuga di dati.
Se nel knowledge base finisce un documento obsoleto o manipolato, l’AI lo userà come se fosse vangelo. Per questo molti progetti seri prevedono revisione umana, logging delle fonti e controlli di qualità.
Se sei un editore, un’azienda o un professionista che produce contenuti, il discorso si allarica. I motori generativi non leggono il web come noi. Cercano blocchi chiari, frasi dirette, dati verificabili, entità ben definite.
Un contenuto pensato solo per Google tradizionale punta alla classica “posizione alta”. Un contenuto pensato per il mondo RAG AI punta a essere recuperato, capito e citato dentro la risposta generata.
Cosa funziona meglio nella pratica?
In altre parole: scrivere per l’AI RAG non significa scrivere “per i robot”. Significa scrivere in modo così chiaro che un sistema di recupero trovi subito il pezzo giusto.
Nei progetti reali, i problemi sono quasi sempre operativi. Eccoli in breve.
Chi progetta bene il RAG AI sa che la parte “generativa” è solo la punta dell’iceberg. Sotto ci sono ingestione, pulizia dati
Non tutto ha bisogno di RAG. A volte basta un buon prompt. Altre volte serve un modello specializzato o un fine-tuning.
Ha senso il RAG AI quando:
Ha meno senso quando:
Se devi portarti a casa una sola frase, questa è quella giusta: il RAG AI non rende l’intelligenza artificiale più “intelligente” nel senso umano, ma la rende più affidabile, più aggiornata e più utile nei contesti reali.
Il modello generativo da solo sa scrivere. Il RAG LLM sa cercare prima di scrivere. E nel momento in cui l’AI entra in azienda, nella sanità, nel diritto, nel supporto clienti e nei motori di risposta, “saper scrivere” non basta più: serve sapere da dove arriva l’informazione.
Chi costruisce prodotti deve smettere di vedere il RAG come un optional tecnologico. Chi fa contenuti deve smettere di pensare solo in termini di parole chiave e posizioni. Il nuovo obiettivo è essere recuperati, compresi e citati dai sistemi che generano risposte. Un buon punto di partenza per sperimentare è iBoomto.
In fondo il RAG intelligenza artificiale risponde a una domanda molto umana: l’AI può essere brava a parlare, ma noi vogliamo che sia anche bene informata.