Connexion
Connexion
Pas de superflu. Juste du neuf et du gratuit. (Démos, crédits, mises à jour et nos coups de cœur)
Merci pour votre abonnement ! Restez à l'écoute pour découvrir nos démos, crédits et mises à jour.
Un modèle d'embedding transforme un texte en vecteur numérique pour retrouver des contenus de sens similaire. Un LLM (anglais : Large Language Model) analyse le langage et génère des réponses. Le premier facilite la recherche sémantique, tandis que le second permet de comprendre et d'exploiter les informations. Dans un système RAG, ils travaillent ensemble pour répondre à des questions à partir de documents.
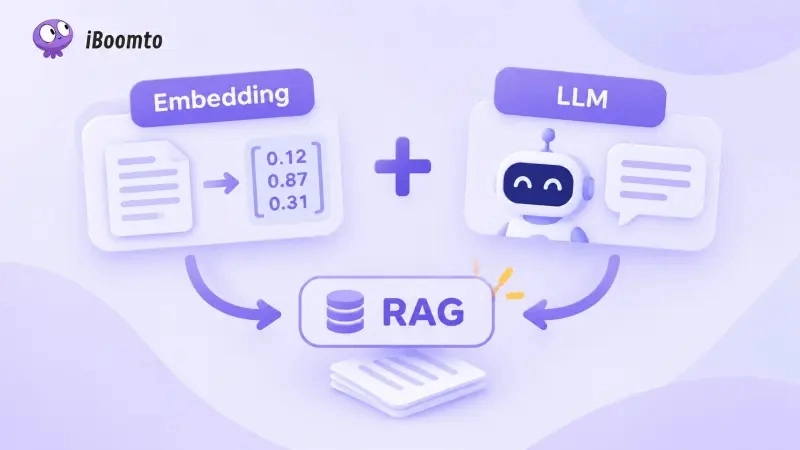
Un modèle d'embedding transforme un texte en vecteur numérique afin de comparer des contenus selon leur sens. Un LLM, lui, comprend le langage et génère des réponses à partir d'une instruction et de son contexte. Dans un système RAG, le premier retrouve les passages utiles dans les documents, tandis que le second les analyse et rédige une réponse.
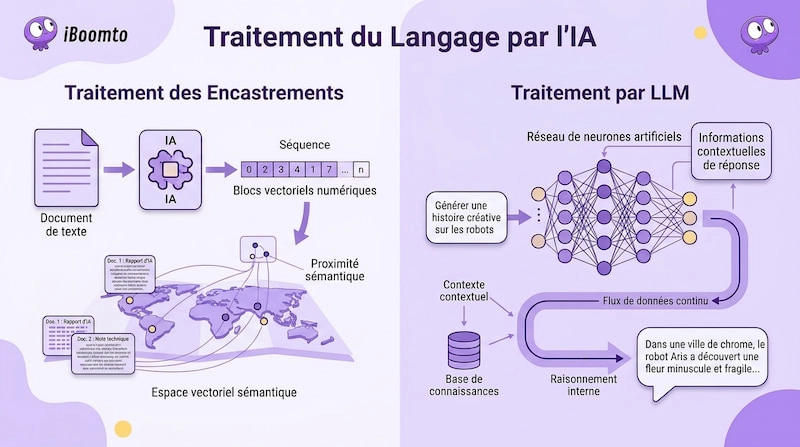
Un embedding est une représentation numérique d'un contenu sous forme de vecteur. Le modèle analyse un texte et le convertit en une série de valeurs qui reflètent certaines caractéristiques de son sens.
Prenons deux phrases : « Comment protéger mes fichiers PDF ? » et « Quelles sont les méthodes pour sécuriser un document PDF ? ». Les mots diffèrent, mais leur sens est proche. Un modèle d'embedding peut donc produire des vecteurs similaires.
Le processus se déroule en trois étapes :
C'est le principe de la recherche sémantique : retrouver des informations pertinentes sans dépendre uniquement des mots exacts utilisés.
Un LLM reçoit une instruction, analyse les tokens qui composent le texte et tient compte du contexte pour générer une réponse.
Les tokens sont des unités de texte qui peuvent correspondre à un mot entier ou à une partie de mot. Grâce à son architecture neuronale, notamment aux mécanismes d'attention des Transformers, le modèle analyse les relations entre ces unités.
Par exemple, si vous lui fournissez un rapport et demandez un résumé, il analyse les informations disponibles pour produire une synthèse structurée. Contrairement à un modèle d'embedding dédié, son objectif principal est de traiter et de générer du langage.
| Critère | Modèle d'embedding | LLM |
|---|---|---|
| Objectif | Représenter le sens des données | Traiter et générer du langage |
| Entrée | Textes et documents | Instructions et contexte |
| Sortie | Vecteurs numériques | Texte et réponses |
| Fonctionnement | Vectorisation et comparaison | Analyse et génération |
| Usages | Recherche sémantique, similarité | Résumé, rédaction, traduction |
| Limites | Ne génère généralement pas de texte | Peut produire des informations incorrectes |
Les deux modèles ne sont donc pas interchangeables. Leurs performances et leurs coûts dépendent aussi de leur taille, du matériel utilisé et du volume de données traité.
Le choix dépend du résultat attendu, mais aussi du volume de documents, du niveau de précision nécessaire et du temps de réponse souhaité.
Pour retrouver des informations dans une grande collection de documents, un modèle d'embedding est généralement adapté.
Imaginons que vous disposiez de plusieurs contrats et que vous recherchiez les clauses relatives à leur date d'expiration. Même si les documents utilisent des formulations différentes, la recherche sémantique peut retrouver les passages qui parlent de durée, de renouvellement ou de fin de contrat.
Le modèle compare les vecteurs de la requête et des documents pour identifier les passages les plus proches. La pertinence dépend toutefois de la qualité du modèle et du découpage des fichiers.
Pour rédiger un email, résumer un rapport ou reformuler un paragraphe, un LLM est plus approprié. Il exploite le texte fourni et produit un résultat adapté à la demande.
Par exemple, un utilisateur peut transmettre un rapport de plusieurs dizaines de pages et demander une synthèse des principales conclusions. Le LLM analyse le contenu disponible et organise les informations selon la consigne. Il peut également reformuler un passage, rédiger un compte rendu ou extraire les idées essentielles.
Un modèle d'embedding convient pour regrouper des textes similaires ou rapprocher des descriptions de produits. Un LLM est plus intéressant lorsque la classification nécessite de comprendre des consignes précises ou d'interpréter le contexte.
Les deux peuvent aussi être associés : le premier repère les contenus proches, le second les analyse et les classe.
Analyser plusieurs documents demande souvent davantage qu'une simple recherche. Il faut retrouver des informations, les comparer, relever des différences et produire une synthèse.
Reprenons l'exemple des contrats. Un utilisateur importe plusieurs fichiers et demande : « Quels contrats arrivent à échéance le mois prochain ? » Le modèle d'embedding aide à retrouver les clauses relatives aux dates d'expiration. Le LLM analyse ensuite les passages récupérés, compare les dates et formule une réponse.
Ce type de besoin concerne aussi bien les équipes administratives que les services financiers ou juridiques, qui doivent régulièrement exploiter plusieurs fichiers. Un assistant IA documentaire peut faciliter ce travail : il permet de poser des questions sur plusieurs documents, de résumer des fichiers, d'extraire des informations, de comparer des documents et de générer des rapports.
| Situation | Solution à privilégier | Point de vigilance |
|---|---|---|
| Retrouver une clause dans des centaines de contrats | Embedding | Précision de la recherche et qualité du découpage |
| Résumer un contrat déjà fourni | LLM | Longueur du contexte et qualité de la synthèse |
| Comparer plusieurs dates ou clauses | Embedding + LLM | Fiabilité de l'extraction et vérification des résultats |
| Classer des textes selon des consignes complexes | LLM ou approche hybride | Complexité de la classification et coût |
| Rechercher rapidement dans une grande base documentaire | Embedding | Latence de l'indexation et de la recherche |
Tips:
Ne choisissez pas un modèle uniquement sur ses performances annoncées. Évaluez-le avec vos propres documents, en tenant compte du coût de traitement, du temps de réponse et de la précision des résultats.
Oui. Les deux modèles peuvent fonctionner indépendamment, mais leurs capacités sont différentes.
Un LLM peut traiter directement un texte fourni dans une instruction. Si vous lui transmettez un contrat et demandez un résumé, aucune recherche vectorielle n'est nécessaire.
La situation change lorsque vous souhaitez interroger une grande collection de documents. Le LLM ne peut pas retrouver automatiquement des informations dans des fichiers auxquels il n'a pas accès. Un modèle d'embedding peut alors faciliter la recherche des passages pertinents.
Un modèle d'embedding peut fonctionner seul pour transformer des descriptions en vecteurs, comparer des documents ou regrouper des contenus similaires.
En revanche, il ne produit généralement pas de synthèse ou d'explication en langage naturel. Pour obtenir une réponse rédigée à partir des résultats, un LLM ou un autre modèle génératif est nécessaire.
Le RAG (anglais : Retrieval-Augmented Generation) associe recherche documentaire et génération de texte. Il permet à un LLM de s'appuyer sur des documents externes pour répondre à une question.
Les documents sont d'abord découpés en passages plus courts, appelés chunks. Un modèle d'embedding transforme chaque passage en vecteur numérique, ensuite enregistré dans un index ou une base de données vectorielle.
Lorsqu'un utilisateur pose une question, le système la transforme également en vecteur et la compare aux documents indexés. Il sélectionne ainsi les passages les plus proches de la requête.
Dans notre exemple, la recherche peut identifier les clauses qui mentionnent la durée, le renouvellement ou la date d'expiration des contrats.
Les passages sélectionnés sont transmis au LLM avec la question initiale. Ils lui apportent des informations supplémentaires pour construire sa réponse.
Le LLM analyse les extraits récupérés et formule une réponse en langage naturel. Il peut ainsi indiquer quels contrats arrivent à échéance le mois prochain, à partir des informations retrouvées.
Dans une base de connaissances IA, les modèles d'embedding, le RAG et les LLM fonctionnent ensemble pour exploiter les informations contenues dans les documents. Cette combinaison permet de transformer un ensemble de fichiers en une source d'informations interrogeable en langage naturel.
C'est notamment le principe de la base de connaissances en ligne d'iBoomto AI.
Les utilisateurs peuvent importer leurs propres fichiers pour créer une base de connaissances et poser directement des questions sur leur contenu. Lorsqu'une question est soumise, le système utilise une recherche hybride pour retrouver les passages pertinents, puis les transmet au LLM afin qu'il formule une réponse à partir des informations disponibles.
Cette approche facilite notamment la consultation des procédures internes en entreprise, la recherche d'informations dans des supports de cours ou l'exploitation de nombreux documents professionnels. Plutôt que de parcourir chaque fichier manuellement, l'utilisateur peut poser directement ses questions à sa base de connaissances et obtenir des réponses à partir des documents importés.
La création d'une base de connaissances avec iBoomto AI se fait en quelques étapes :

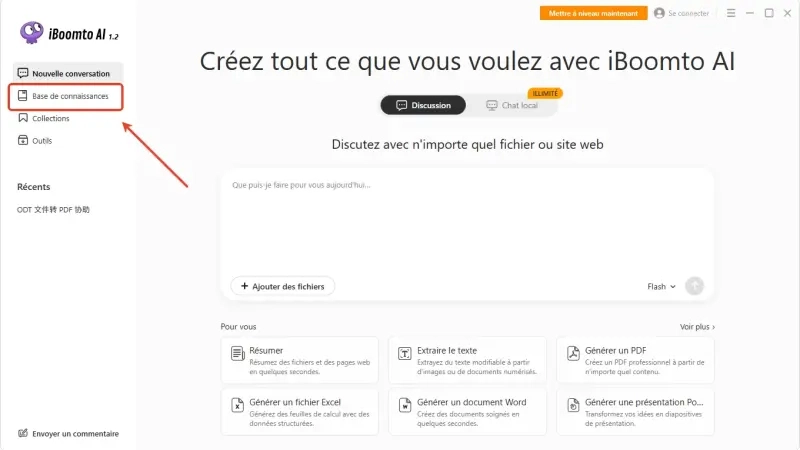
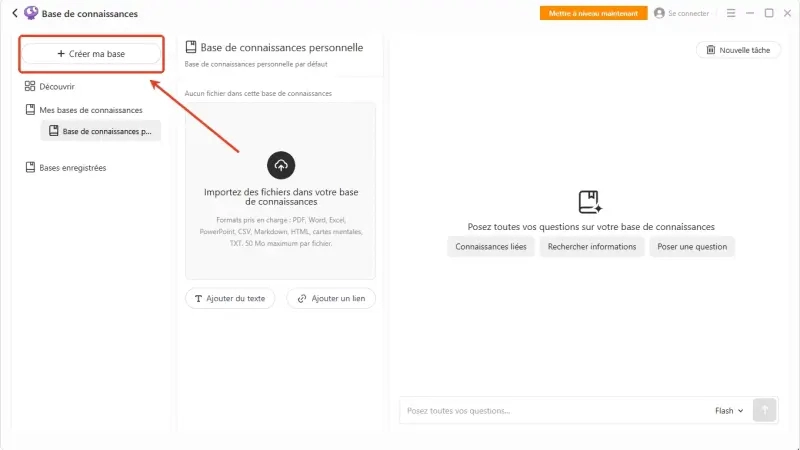
Vous pouvez ainsi consulter et exploiter vos documents sans avoir à ouvrir chaque fichier individuellement.
Même associés, les modèles d'embedding et les LLM présentent certaines limites.
Deux contenus proches dans l'espace vectoriel ne répondent pas nécessairement au même besoin. Le choix du modèle doit tenir compte de la langue et du domaine traité.
Des passages trop courts peuvent perdre leur contexte, tandis que des passages trop longs peuvent mélanger plusieurs sujets. Un découpage adapté améliore la recherche.
Un LLM peut produire une réponse convaincante mais incorrecte. Le RAG réduit le risque d'informations non fondées, sans supprimer complètement les erreurs.
Vérifiez comment les documents sont traités et stockés, surtout lorsqu'ils contiennent des informations professionnelles. Les coûts et les temps de réponse dépendent du volume de données, des modèles et des ressources nécessaires.
Un modèle d'embedding sert à représenter et à rapprocher des contenus. Un LLM traite le langage et génère des réponses. Ils peuvent fonctionner séparément ou être associés dans un système RAG.
Tout dépend donc de votre objectif : retrouver une information, comparer des fichiers ou produire une réponse à partir de plusieurs sources.
Pour faciliter ce travail documentaire, iBoomto AI propose des fonctions de questions-réponses, de résumé, d'extraction et de gestion documentaire. Sa base de connaissances en ligne est une solution d'IA reposant sur la technologie RAG : elle combine la recherche documentaire et les LLM pour permettre aux utilisateurs de poser des questions et d'obtenir des réponses à partir de leurs propres documents importés.
 Télécharger gratuitement