Connexion
Connexion
Pas de superflu. Juste du neuf et du gratuit. (Démos, crédits, mises à jour et nos coups de cœur)
Merci pour votre abonnement ! Restez à l'écoute pour découvrir nos démos, crédits et mises à jour.
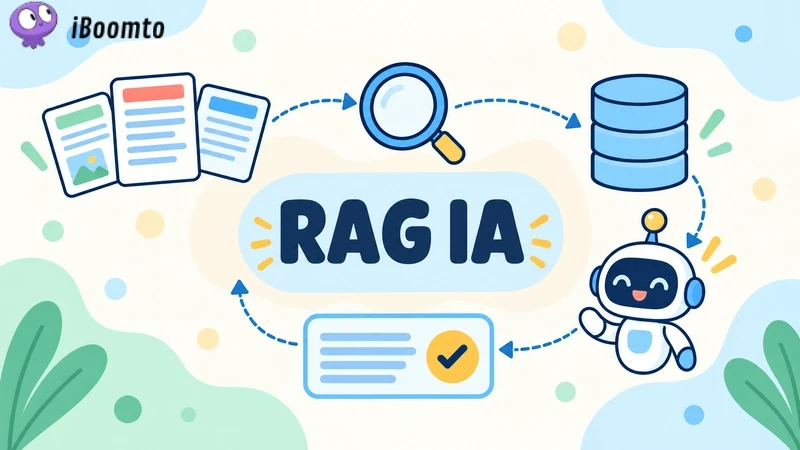
Le RAG IA enrichit les réponses d'un modèle d'IA en lui fournissant des informations pertinentes issues de sources externes, comme des documents internes ou une base de connaissances.
Pourquoi ChatGPT et les autres LLM peuvent-ils avoir du mal à répondre à des questions sur des PDF internes, des manuels produits ou des procédures récemment mises à jour ? L'une des explications possibles est l'absence d'un mécanisme permettant au modèle de rechercher des informations pertinentes et à jour dans des sources externes. Le RAG est l'une des approches qui répondent à ce besoin. Le RAG extrait les informations pertinentes avant de générer des réponses et utilise le contenu extrait comme contexte pour le modèle. Ce guide explique ce qu'est le RAG, comment il fonctionne et dans quels cas il est utile.
En tant que technologie permettant au LLM (grand modèle de langage) de récupérer des informations dans des sources externes et de les utiliser pour générer des réponses mieux contextualisées, le RAG joue un rôle important dans le processus de génération de réponses par les outils d'IA.
La définition de RAG est « génération augmentée par récupération » (anglais : retrieval-augmented generation). Cette technique d'IA générative extrait des informations pertinentes de bases de connaissances externes (telles que des bases de connaissances privées contenant des documents internes ou des processus spécifiques à l'entreprise), puis les intègre à un grand modèle de langage (LLM) afin de générer des réponses plus contextuelles. Les systèmes d'IA peuvent ainsi répondre aux questions à partir d'informations spécifiques et actualisées sans nécessiter un réentraînement complet du modèle. Toutefois, la confidentialité de ces données dépend des mesures de sécurité et de gestion des accès mises en œuvre.
Connecter un LLM à une base de connaissances externe lui donne un accès direct à des informations spécifiques et aux données les plus récentes, sans réentraînement complet. C'est là qu'intervient la technologie RAG. Le RAG fournit au modèle des passages issus de sources choisies : ses réponses reposent ainsi sur des informations précises et à jour plutôt que sur ses seules données d'entraînement. Il convient toutefois de souligner que le RAG peut améliorer la pertinence des réponses, mais il n'en garantit pas l'exactitude factuelle. Le LLM peut toujours produire des informations erronées ou des hallucinations. Une vérification manuelle reste donc nécessaire après chaque réponse.
Le RAG et le fine-tuning sont deux méthodes courantes d'optimisation des performances des grands modèles de langage (LLM), mais elles répondent à deux problèmes différents. Le RAG enrichit le modèle en récupérant des connaissances externes, principalement pour lui fournir des informations spécifiques et actualisées. Le fine-tuning, quant à lui, utilise les données d'entraînement pour ajuster les paramètres du modèle et ainsi améliorer ses performances sur une tâche spécifique.
Outre ces différences, il existe plusieurs autres distinctions subtiles entre les deux :
| Critère | RAG | fine-tuning |
| Modification des paramètres du modèle | Généralement, aucune modification | Les paramètres du modèle sont ajustés |
| Mise à jour des connaissances | Mise à jour de la base de connaissances externe et de son index | Un nouvel entraînement est généralement nécessaire pour apprendre de nouvelles informations ou de nouveaux comportements |
| Traçabilité des informations | Possibilité de fournir des sources à l'appui des réponses | Le modèle ne fournit pas automatiquement les sources de ses données d'entraînement |
| Cas d'utilisation typiques | Base de connaissances privée d'entreprise, questions-réponses sur des documents, service client automatisé | Génération de contenus dans un format précis, adaptation du style rédactionnel, classification spécialisée |
Pour retenir l'essentiel, distinguez les deux objectifs : le RAG apporte au modèle les informations nécessaires pour répondre ; le fine-tuning adapte son comportement à une tâche, à un format ou à un style particulier.
En tant que technologie capable de récupérer et d'analyser des documents, le RAG repose sur plusieurs composants qui collaborent pour retrouver les informations pertinentes et les transmettre au modèle de langage.
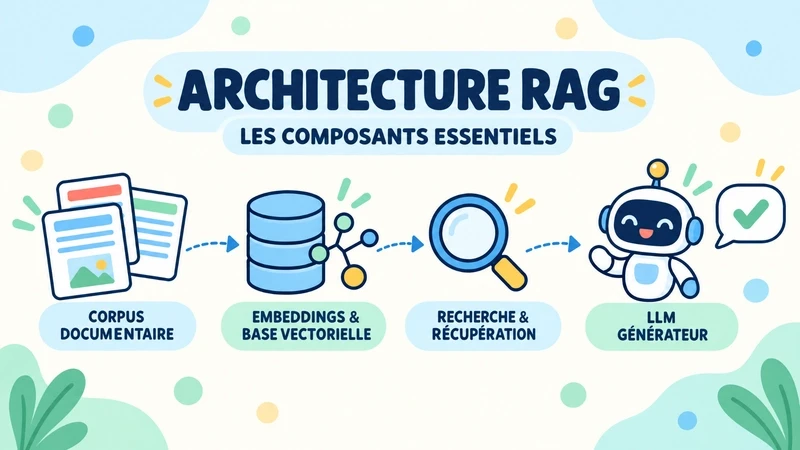
Dans l'architecture RAG, le corpus documentaire et la base de connaissances sont étroitement liés mais ont des fonctions différentes.
Le corpus documentaire regroupe les sources utilisées par le système RAG : fichiers PDF, procédures internes, documentation technique, pages web ou autres documents pertinents. En l'absence de ce corpus, le système ne peut pas s'appuyer sur les documents concernés et risque de produire une réponse incomplète ou inexacte à partir des seules informations dont le modèle dispose déjà.
La base de connaissances traite, segmente, indexe et organise les documents pour retrouver rapidement les informations pertinentes à partir de la requête d'un utilisateur et les transmettre au LLM, qui génère alors sa réponse. Sans elle, le système peine à localiser efficacement les bonnes informations, d'où des réponses incomplètes ou inexactes, voire des hallucinations.
Le modèle d'embedding transforme les textes en vecteurs numériques, tandis que la base de données vectorielle stocke ces représentations afin de faciliter la recherche sémantique.
Un modèle d'embedding convertit des segments de documents et des requêtes utilisateur en vecteurs numériques qui en représentent la signification sémantique, permettant ainsi au système d'effectuer des correspondances fondées sur le sens plutôt que de se reposer uniquement sur des mots-clés. En l'absence d'un tel modèle — ou d'autres mécanismes de représentation ou de recherche sémantique —, il serait difficile pour le système de réaliser une recherche sémantique vectorielle, ce qui pourrait entraîner l'omission d'informations pertinentes.
Une base de données vectorielle stocke les vecteurs et leurs métadonnées et gère les recherches par similarité, facilitant ainsi le repérage rapide du contenu correspondant à la requête d'un utilisateur. Sans elle, le système peinerait à mener des recherches par similarité efficaces et à retrouver précisément les bons segments de documents.
Note : Le RAG ne nécessite pas nécessairement une base de données vectorielle dédiée ; d'autres bases de données ou moteurs de recherche prenant en charge la recherche vectorielle peuvent également être utilisés.
Selon l'architecture, le moteur de recherche et le mécanisme de récupération peuvent être intégrés ou séparés. Ensemble, ils identifient les passages les plus pertinents pour répondre à la requête. Le premier se charge de la recherche d'informations proprement dite, tandis que le second organise et optimise l'ensemble du processus de récupération.
Si l'un de ces composants fait défaut — et qu'aucun outil de récupération alternatif n'est disponible —, le processus de récupération ne peut fonctionner efficacement. Le système risque alors de récupérer des passages incomplets ou peu pertinents, ce qui peut nuire à la qualité des réponses du LLM.
Le LLM formule une réponse en langage naturel à partir des informations récupérées et de la question de l'utilisateur.
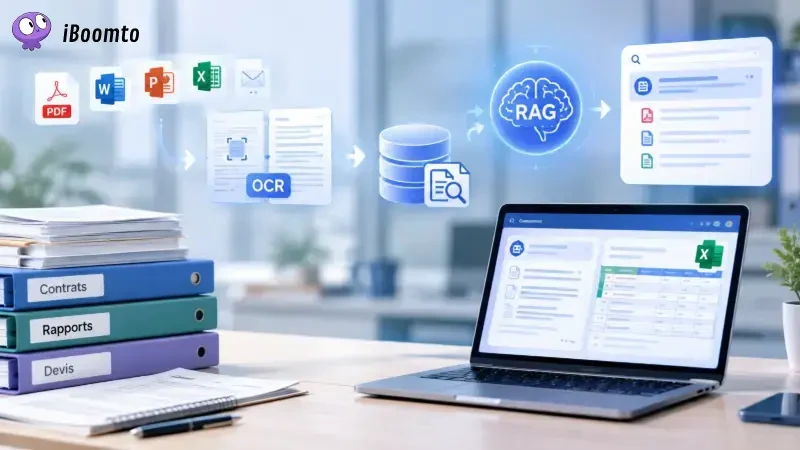
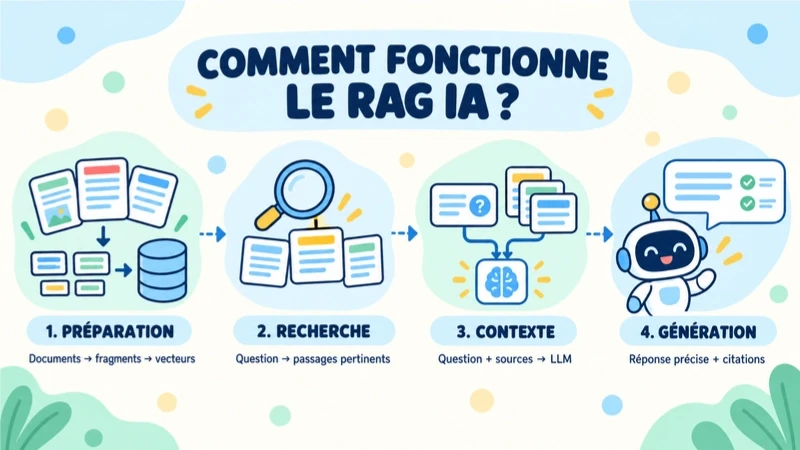
Le RAG repose sur plusieurs étapes : la préparation des documents, la recherche d'informations pertinentes, l'enrichissement du contexte et la génération d'une réponse. En résumé, lorsqu'un utilisateur pose une question, le système recherche d'abord des informations pertinentes dans une base de connaissances externe, puis les transmet à un grand modèle de langage (LLM) en vue de la génération d'une réponse adaptée aux besoins spécifiques de l'utilisateur. Le processus se déroule comme suit :
Les documents sources (PDF, pages web, contenu de bases de données, etc.) sont décomposés en unités plus petites, convertis en vecteurs grâce à un modèle d'embedding, puis stockés dans une base de données vectorielle.
Lorsqu'un utilisateur pose une question, celle-ci est convertie en vecteur par le même modèle d'embedding. Le système identifie ensuite les fragments de contenu sémantiquement les plus similaires dans la base de données vectorielles.
Le contenu récupéré est intégré à la question de l'utilisateur dans un prompt, qui est ensuite transmis à un grand modèle de langage. Cela donne au modèle les moyens de croiser ces informations pour produire une réponse plus précise et mieux adaptée au contexte.
Les grands modèles de langage utilisent ces données pour organiser et générer la réponse. Selon le système, celle-ci peut également comporter des références aux sources afin de faciliter la vérification.
La qualité d'un système RAG dépend notamment de sa capacité à récupérer les passages pertinents et à produire des réponses exactes, cohérentes avec les sources et adaptées à la question. Ces aspects doivent donc être au cœur de votre évaluation. Pour évaluer la qualité d'un système RAG, vous pouvez utiliser iBoomto AI pour préparer un jeu de tests comprenant des questions types, des réponses de référence et les passages sources attendus, et ainsi l'évaluer selon les cinq dimensions suivantes :
Vous pouvez également utiliser iBoomto AI pour noter les réponses générées et comparer les résultats aux critères définis au préalable.

 Télécharger gratuitement
Le RAG IA ne garantit jamais à lui seul des réponses exactes. Il apporte des avantages par rapport à un LLM utilisé seul, mais présente aussi des limites à connaître.
| Avantages | Limites |
| Les réponses peuvent être vérifiées à partir des sources récupérées, ce qui facilite la détection de certaines hallucinations. | Les performances dépendent fortement de la qualité de la recherche. |
| Les connaissances peuvent être actualisées en mettant à jour les documents et, si nécessaire, leur index, sans réentraîner systématiquement le LLM. | Le système nécessite une maintenance régulière de la base de connaissances et du mécanisme de recherche. |
| Le RAG peut éviter le coût d'un fine-tuning lorsqu'il suffit d'apporter des informations externes au modèle. | Les systèmes RAG peuvent rencontrer des difficultés lorsque la réponse nécessite de croiser des informations complexes provenant de nombreux documents. |
Bien que le RAG puisse améliorer la pertinence des réponses en intégrant des informations externes, il ne garantit pas leur exactitude. Plusieurs facteurs peuvent conduire à des réponses incorrectes.
Pour limiter ces risques, mettez régulièrement à jour votre base de connaissances, améliorez les mécanismes de recherche et vérifiez que les réponses générées par le LLM sont bien étayées par les sources disponibles.
Le RAG peut être utilisé dans différents contextes professionnels, notamment pour rechercher des informations dans des documents internes, assister les équipes et répondre aux questions des clients. En donnant accès à des informations externes pertinentes, le RAG peut faciliter certaines tâches de recherche documentaire et de génération de réponses.
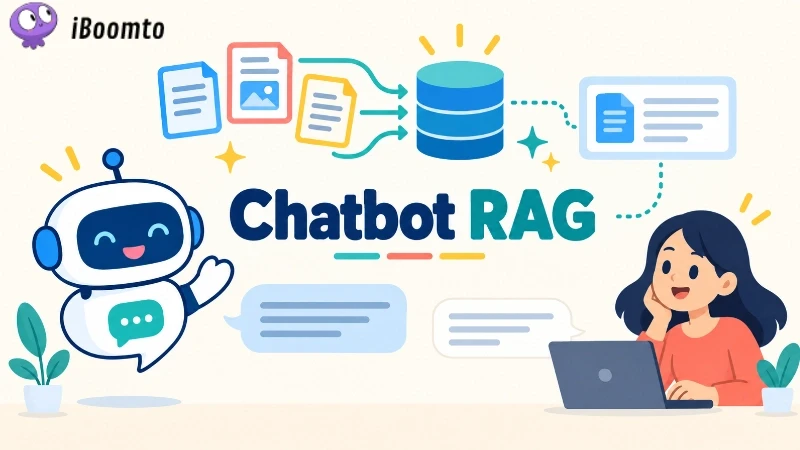
Les chatbots RAG constituent l'un des domaines d'application les plus courants de RAG, notamment pour automatiser une partie du service client. Ces chatbots peuvent accéder à la base de connaissances interne de l'entreprise et puiser dans des ressources telles que les fiches techniques, les FAQ, les procédures de service après-vente et les conditions générales de vente afin de répondre aux questions des utilisateurs.
Le RAG peut également faciliter la recherche documentaire dans les milieux universitaires et professionnels, ainsi que l'analyse commerciale et l'aide à la décision.
RAG IA s'appuie sur des informations externes pour aider les modèles de langage à produire des réponses plus pertinentes. En se connectant à des bases de connaissances locales ou privées, les entreprises peuvent utiliser leurs documents, processus et données internes pour obtenir des réponses personnalisées et adaptées à leurs besoins, sans nécessiter un réentraînement complet du modèle.
Toutefois, la qualité de la réponse dépend de facteurs tels que la fiabilité de la base de connaissances, l'efficacité du mécanisme de recherche et la capacité du modèle à interpréter les informations fournies. Par conséquent, bien que le RAG offre une solution efficace pour exploiter les connaissances internes, il est toujours recommandé de vérifier manuellement les réponses afin de minimiser les risques potentiels.